
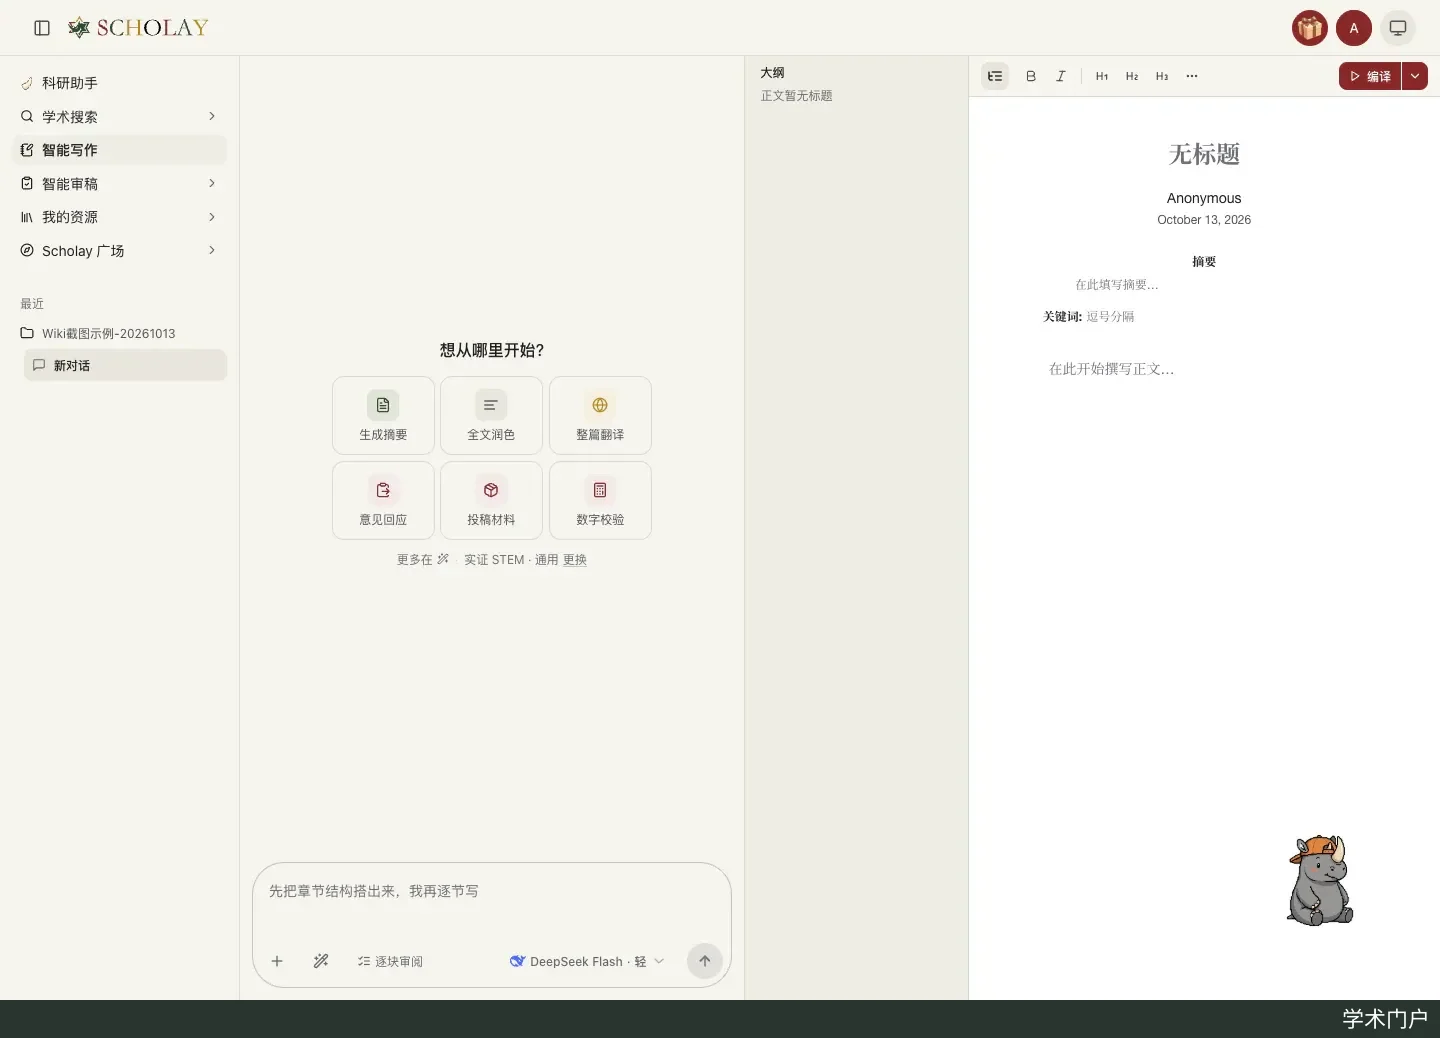
图为 Scholay Prism 开始写作界面。
一般研二的学生,论文快写完的时候,手上都有一份问卷数据。今年办公室的同事,给他带的研究生看了一眼新做的统计设计,说了一嘴:“先去看看多层模型。”他那个研究生的数据, 大概是几十个班级的学生,每人一行,记录课外阅读时间和阅读成绩。不知道这位同学对这个方法理解了没有, 但是从现场的气氛来看,我觉得他可能在方法学上欠的债比较多。 不光是统计方法,甚至是文献写作方法、管理方法,尤其是智能化的时代,新的写作方法。
首先,弄清方法本身
说到多层模型,在我治学5年内,先后用这种方法做了很多文章,今天还刚刚在研究方法站 2026 年 10 月 20 日发布了《嵌套数据为什么要用多层模型》。这个东西, 在教育学领域,以课堂为单位的研究中,方法比较好用,但坑也比较多。
- 一个深坑:不能直接回归:同班学生共享老师和课堂环境,彼此更相似,而普通最小二乘假定观测相互独立,结果会把标准误算得过小。
- 两个极端与折中:完全合并只拟合一条线,压掉了组间差异;完全不合并给每个班单独估计,小班估计不稳,而且班级虚拟变量会与班级层面的自变量共线。多层模型取部分合并:各班有自己的参数,但受一个班级层面分布约束,信息少的班会更多向总体均值收缩。
- 空模型与 ICC:先拟合 yᵢⱼ = γ₀₀ + u₀ⱼ + eᵢⱼ,组间方差 τ₀₀、组内方差 σ²,ICC ρ = τ₀₀ /(τ₀₀ + σ²),即总方差中落在班级之间的比例。
- 设计效应:约等于 1 +(平均组规模 − 1)× ICC,表示相比同样本量的简单随机抽样,抽样方差被放大的倍数。
- 随机截距与随机斜率:允许各班平均水平不同,也可以允许“阅读时间对成绩的影响”在班级间不同。
其次,把核心文献搞明白
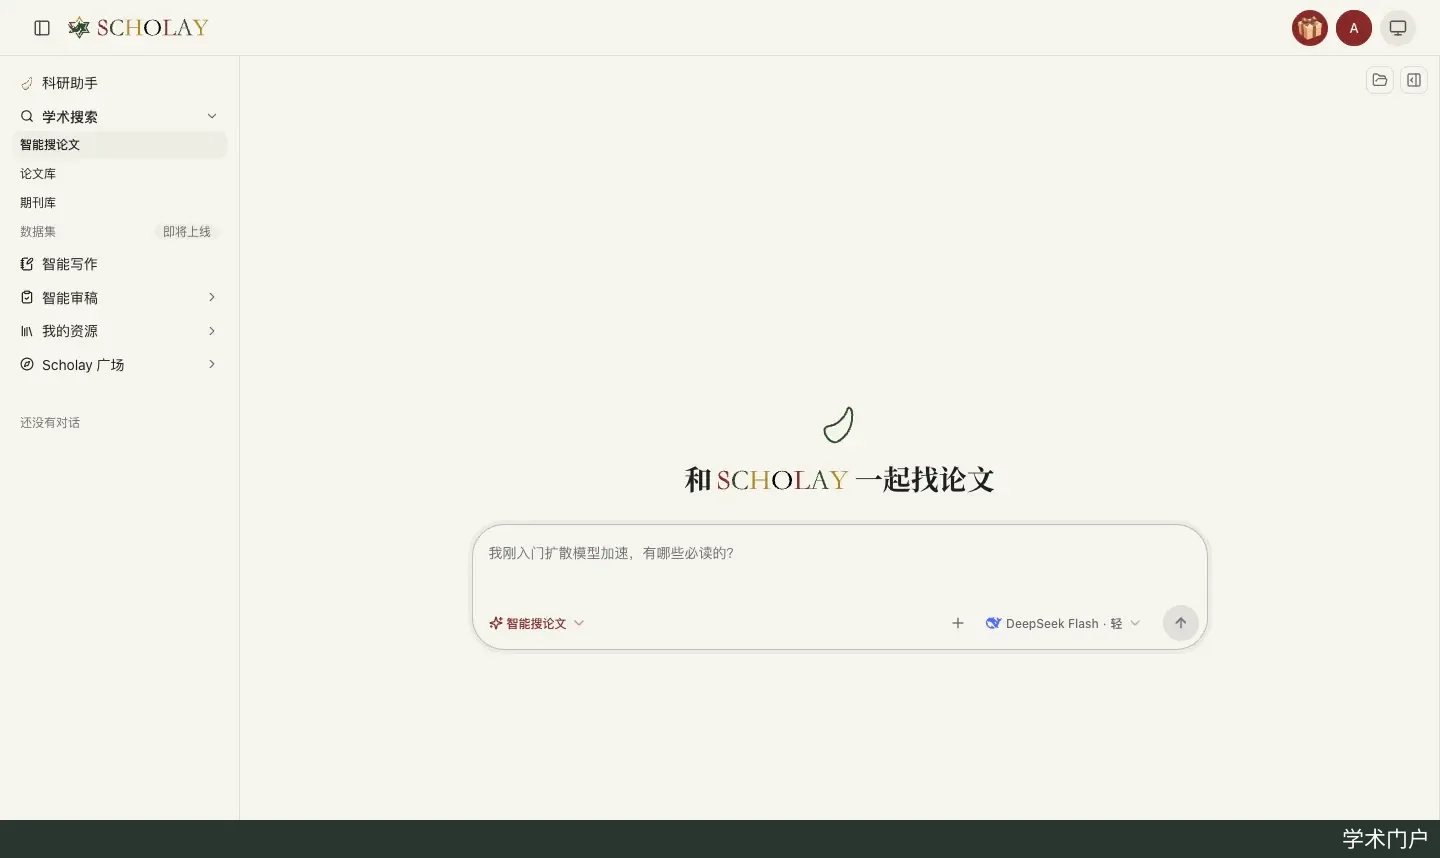
教育研究里大家具体怎么设定模型、报告什么指标。我现在比较懒了,一般关键词一时写不准,就打开 Scholay 的智能搜索,直接用一句话描述,比如:“教育研究中用多层模型分析学生嵌套于班级的数据,关注 ICC 报告和随机斜率设定。”
和比较时髦的鸡皮提,克劳德类似。
智能搜索会拆概念、换术语(同一概念有“多层模型”“混合效应模型”等多种叫法时尤其有用),把论文按轮次返回。挑到一两篇合适的种子论文后,他再沿引用和参考文献往外扩展。其实正常来讲做研究还是要所有的平台都要结合着用, 懒得找图片,我就简单都用这同一个来做描述。
已经知道作者或题名的经典文献,则切到传统搜索直接查,按年份和文献类型筛选。
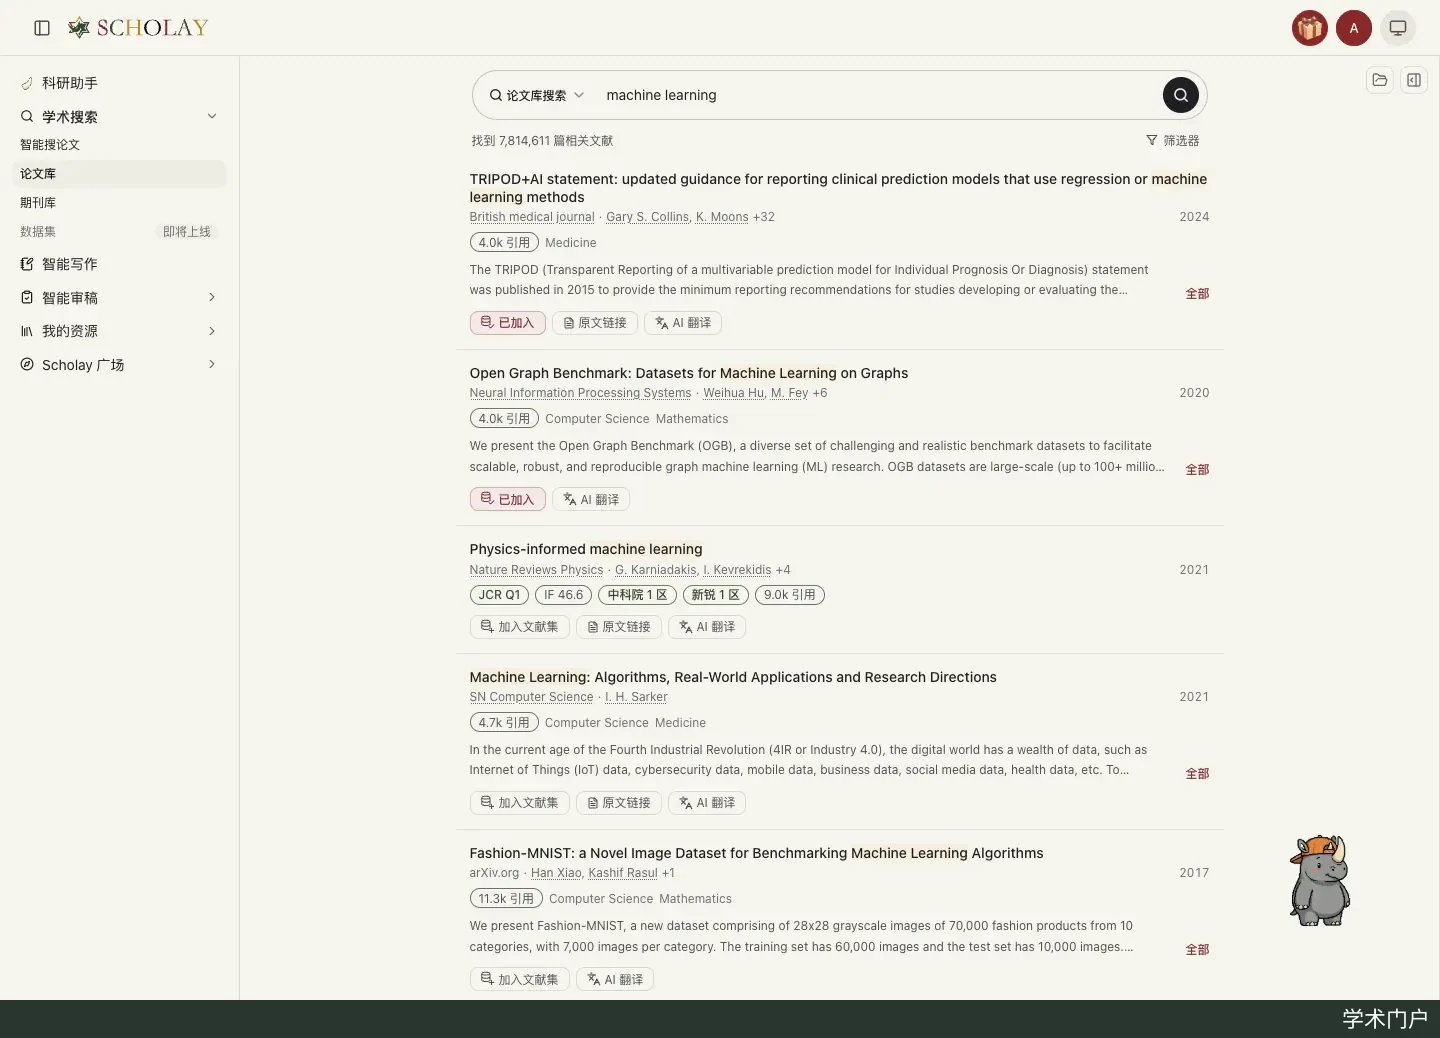
图为传统搜索(论文库)的结果列表。来源:Scholay Wiki。
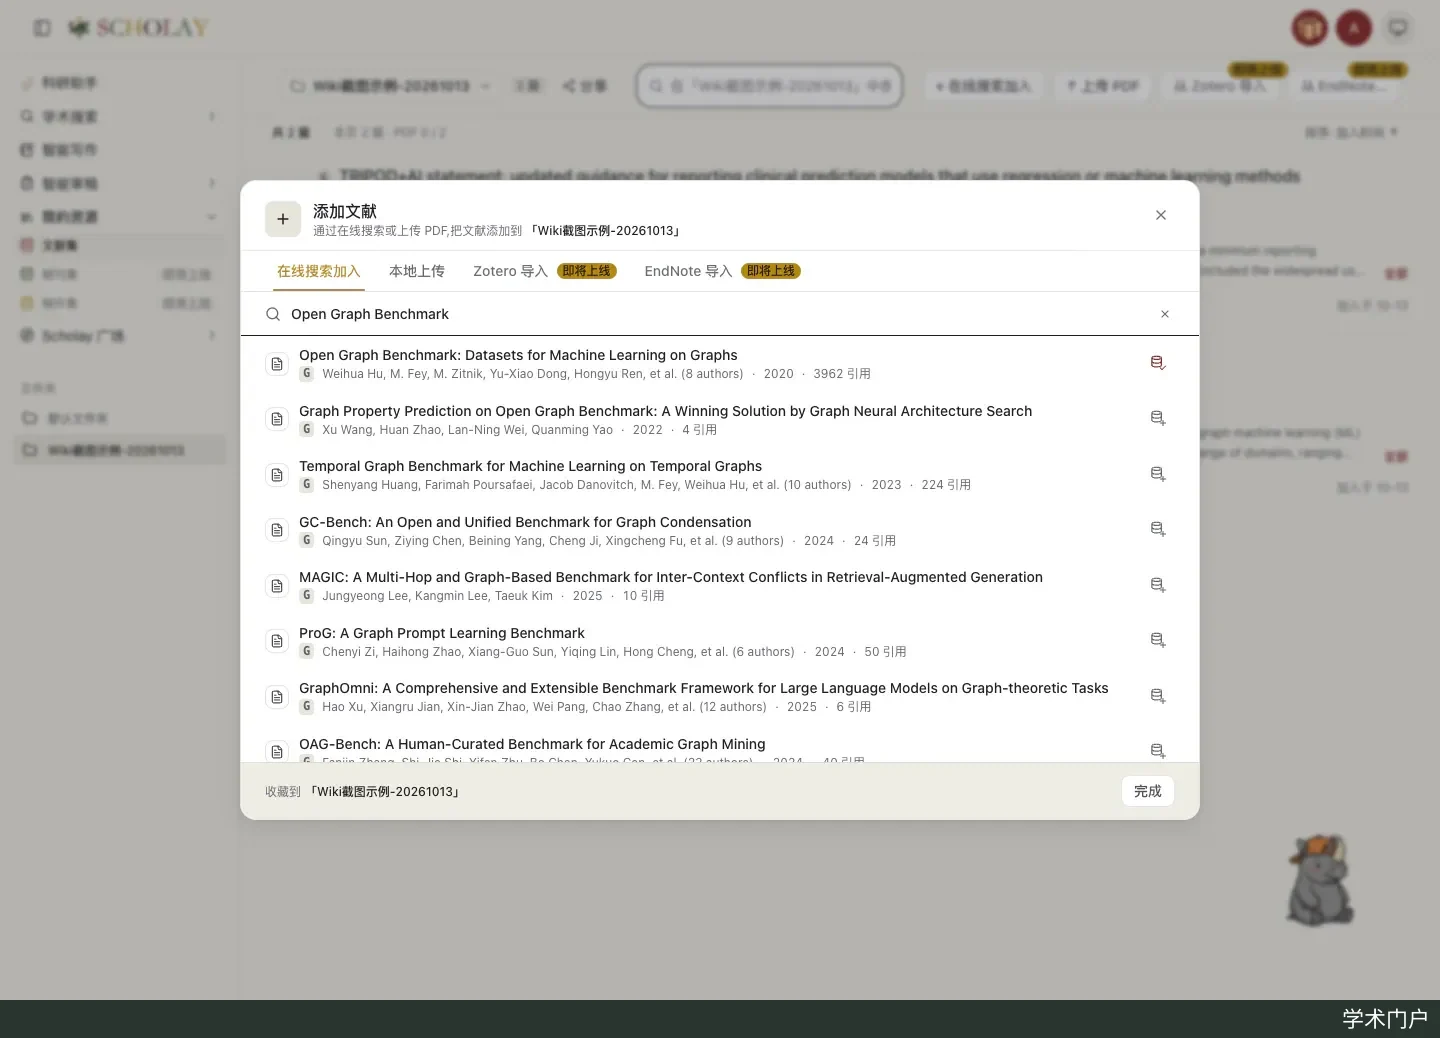
图为个人文献集的在线搜索加入。来源:Scholay Wiki。
把资料和数据都做好整理
智能写作里新建项目,把文献、问卷说明和数据集集中放进去。在同一个项目里,要梳理清楚:先拟合空模型看 ICC,再加入学生层面的阅读时间,最后检验随机斜率;同时整理需要报告的方差成分。对应的论文最好都把标签做好,也做好分类。
模型最终怎么设定、结果意味着什么,还是得自己判断并与导师讨论;项目的作用是让文献、数据和思路始终在一处,后面写开题和组会汇报时直接调用。
再自查一遍
方法部分其实用 Scholay Prism 写:在 LaTeX 工作区里插入公式和引用,让 AI 润色段落,并开启“逐块审阅”逐项决定接受哪些修改,最后编译 PDF。
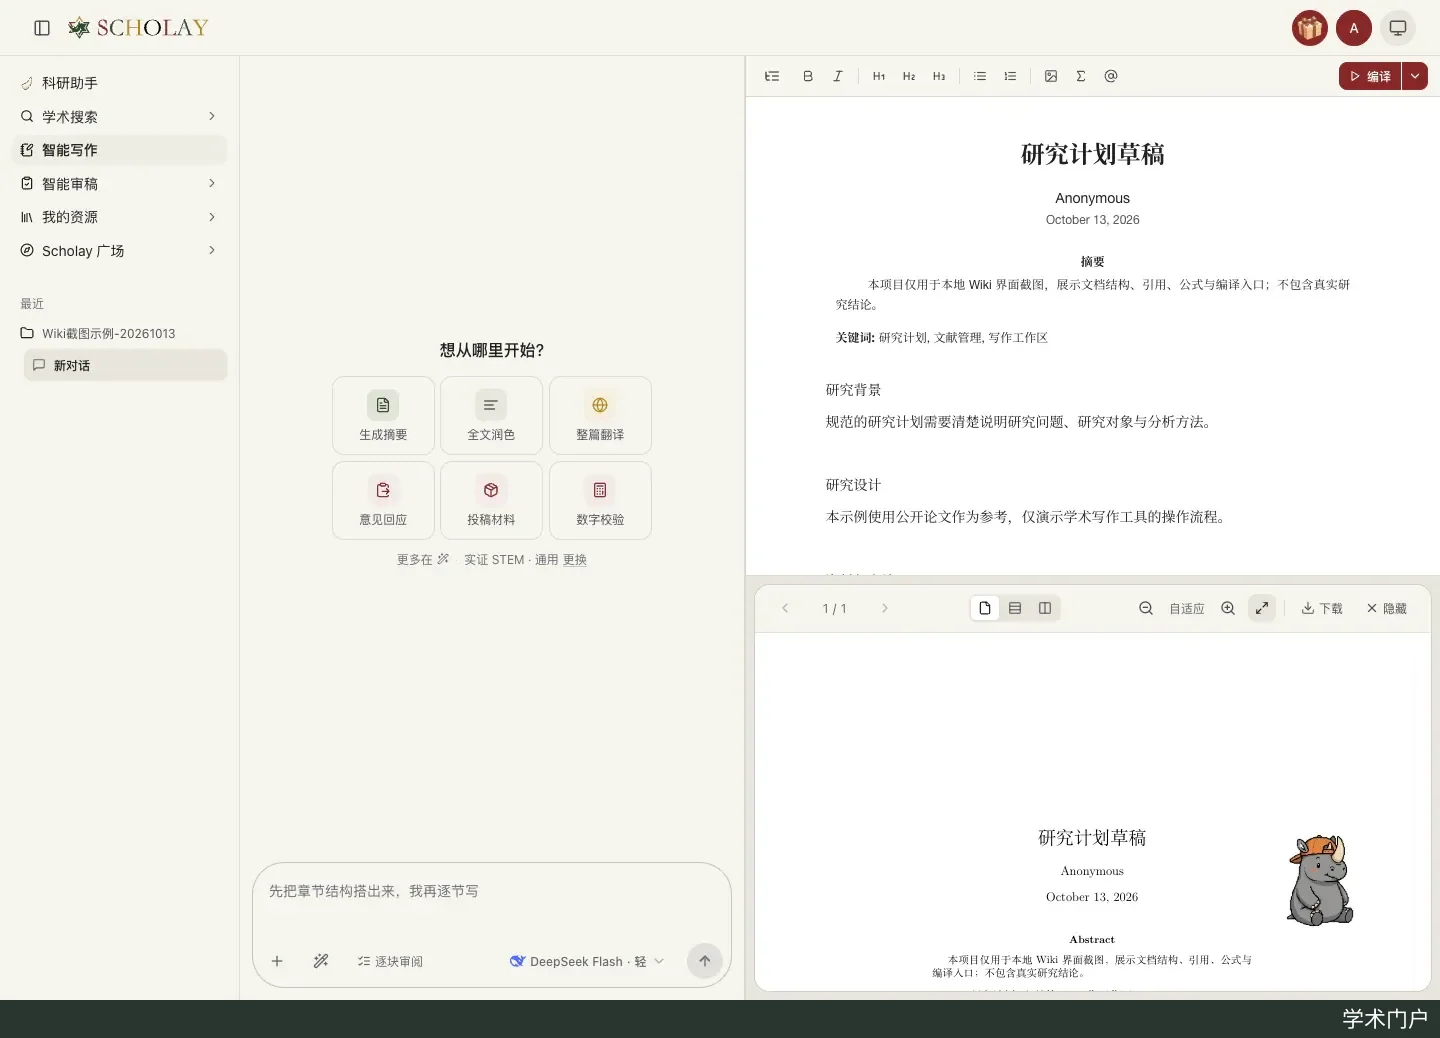
图为 Prism 写作工作区,AI 修改处于逐块审阅待确认状态。来源:Scholay Wiki。
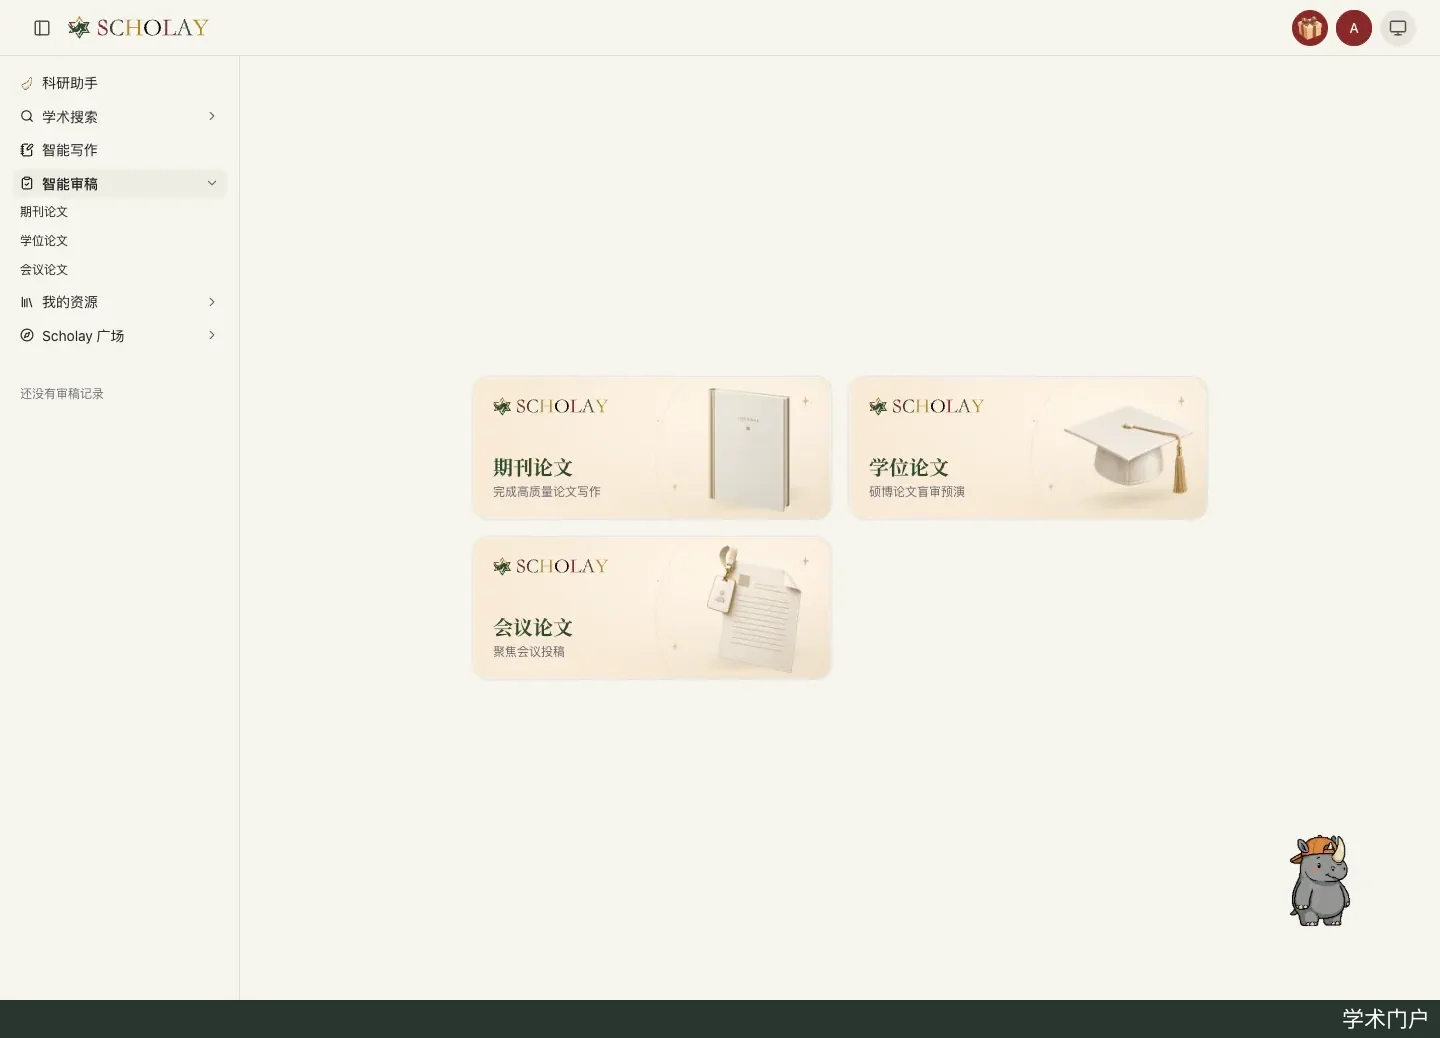
图为智能审稿入口。来源:Scholay Wiki。
初稿完成后,用**智能审稿,**核对 AI 识别的标题和关键词,填写学校、学位与学科背景,得到审稿人 A、B、C 和主审报告。这个还挺有意思的,总体来讲就是用来看看,别人用毒舌的方式怎么评论自己的初稿。
写在最后
多层模型本身不复杂,难的是从“知道有这个方法”走到“在自己的数据上正确用起来”。这一趟用到的,是 Scholay 已经提供的几个环节:智能搜索找文献、文献集存资料、智能写作管项目、Prism 写作、智能审稿自查。