
研究者在图书馆用笔记本电脑浏览论文检索结果。屏幕为无品牌的示意界面,并非 Semantic Scholar 网站截图。AI 生成示意图。
Semantic Scholar 是艾伦人工智能研究所(Ai2)运营的免费学术搜索引擎。网页端可按领域、日期和出版类型筛选,论文页提供 AI 生成的 TLDR 一句话摘要和“高影响引用”标记,同一套数据还通过 Academic Graph API 免费开放。本文依据官网与 API 文档(2026 年 10 月查阅),给出网页检索步骤和 4 个可复用的 API 请求,并说明结果怎么判读、数据有哪些缺口。
网页检索与结果筛选
网页检索的入口是 semanticscholar.org 首页的检索框,可以输入论文标题、作者名、主题词或关键词。先要知道一条限制:官方 FAQ 写明,网页检索不支持布尔运算符和通配符,只支持引号短语。也就是说,在网页上输入 screening AND automation 或 screen* 不会按逻辑运算执行;要固定一个词组,就用引号写成 "systematic review"。需要“与、或、非”组合时,改用下文的 API 批量检索。
结果页的筛选栏用来缩小范围。官方教程视频列出的筛选维度是领域(Field of Study)、日期范围(可直接选 This Year)、出版类型(Publication Type)、作者(Authors)以及期刊与会议(Journals and Conferences);Wentworth 理工学院图书馆的使用指南还列出 Has PDF,即只看有可读 PDF 的结果。FAQ 列出四种排序:相关度、被引次数、最具影响力论文和最新发表,在结果页右上角切换。界面文字可能随改版调整,以当前页面为准。
用领域筛选前,要先知道标签是怎么来的。FAQ 说明,领域由机器学习分类模型根据标题和摘要判定,每篇论文最多 3 个领域;分类目前只覆盖英文论文,标题过于含糊时可能不分配任何领域。举个例子:一篇只有中文标题和摘要的教育学论文,在库里可能没有任何领域标签,勾选 Education 后它就从结果里消失了。所以查全要求高的检索,先不加领域筛选看一遍总量,再加筛选比较差异。
网页示例:找近几年带全文的筛选自动化研究
- 检索框输入:
"systematic review" screening automation - 领域勾选 Computer Science 和 Medicine,日期范围选最近几年。
- 出版类型按需要选择(例如只看综述),再勾选 Has PDF。
- 先按相关度浏览前两页,再切换到按最新发表排序,看近期进展。
判读时注意:结果数会随筛选大幅变化,被筛掉的论文不一定不相关,可能只是缺少领域标签或 PDF 链接。
论文页、作者页与邮件提醒
点开一篇论文进入论文页。如果标题下方有 TLDR,那是系统自动生成的一句话摘要,概括研究目标和主要结果。官方 TLDR 介绍页称,这项功能以测试版形式覆盖近 6000 万篇计算机科学、生物学和医学论文(页面未标注更新日期);FAQ 也写明 TLDR 目前限于计算机科学和生物医学领域。TLDR 大约 20 个英文词,适合在结果列表里快速初筛,但它是模型生成的文字。Semantic Scholar 在 FAQ 中提醒,语言模型生成的文本可能含有不易察觉的事实错误,应尽量核对。决定一篇论文要不要细读,至少回到摘要核对一次。
论文页下方的引用列表可以按引用类型和影响力筛选。官方把引用意图分为三类:背景(Background)、方法(Method)和结果(Result);部分引用会被标为 Highly Influential(高影响引用),表示被引论文对施引论文影响显著。FAQ 说明,高影响引用由机器学习模型判断,依据包括引用次数和引用处的上下文;引用意图和高影响标记都依赖系统能否拿到施引论文的全文。因此“高影响引用为 0”不等于没有人认真用过这篇论文,可能只是相关全文没有进库。实际用法是:在引用列表里按 Most Influenced Papers 排序,或筛选 Cites Methods,快速找到沿用某个方法的后续研究。
作者页由系统自动生成:Semantic Scholar 从公开来源和出版合作方汇集元数据,再用作者消歧模型把论文归到同一人名下,2021 年 6 月起使用的模型叫 S2AND。官方承认同名作者仍可能被混在一起,所以查看他人的作者页时,先抽查几篇论文的机构和合作者是否一致。如果是自己的页面出错,可以在姓名下方点击 Claim Author Page 认领,提交机构、研究领域、ORCID、个人主页等材料;用论文中出现过的邮箱提交,通常审核更快。认领通过后可以增删论文、修改作者信息。作者页显示的 h 指数只基于站内可见的论文和引用,官方明确不建议拿它做横向比较或科研评价。
邮件提醒需要先注册免费账户。官方提供四类提醒:
- 作者提醒:在作者页左栏点 Create Alert,可选择追踪该作者的新引用或新论文;
- 论文提醒:在论文摘要下方点 Create Alert,追踪这篇论文的新引用;
- 主题提醒:在主题页描述下方创建,推送提到该主题的新论文;
- 研究推送(Research Feed):给 5 篇相关论文点 More Like This、3 篇不相关论文点 Less Like This 后,自动开始邮件推送。
在账户设置的 Alert Preferences 里,可以修改接收邮箱,选择每天或每周发送一次,并逐条开关或删除提醒。
Academic Graph API 调用
Academic Graph API 的基础地址是 https://api.semanticscholar.org/graph/v1,可查询论文、作者、引用、参考文献和发表渠道。官方 API 页面说明:多数接口无需认证即可免费调用,但所有未认证用户共享每秒 1000 次的请求额度,高峰期还可能被进一步限流;部分接口(例如数据集下载链接)必须使用 API key。个人 key 的起始速率是所有接口合计每秒 1 次,经审核后可能获得略高的速率。
这两个数字容易看反。每秒 1000 次是全球匿名用户共用的总量,你实际能分到多少并不确定;每秒 1 次则是单独给你的额度。好比食堂里 1000 个座位所有人随便抢,和给你预留一个固定座位的区别。批量任务更适合申请 key,并在脚本里让每次请求至少间隔 1 秒;收到 HTTP 429 表示请求过快,需要放慢。
申请入口是 API 页面上的 Request an API Key 表单,key 通过邮件发送,不要分享给他人;官方没有公布审核时长。调用时把 key 放在请求头 x-api-key 中(区分大小写)。使用前还应读一遍 API 许可协议(页面标注最后更新于 2023 年 5 月 17 日):在网站或出版物中使用这些数据时需注明来自 Semantic Scholar,用 API 结果撰写科研论文时需引用《The Semantic Scholar Open Data Platform》;数据本身另受 CC BY-NC、ODC-BY 等许可约束。官方教程还建议:fields 只请求需要的字段,大量数据优先用批量接口,超出 key 速率的需求改为下载数据集在本地查询。
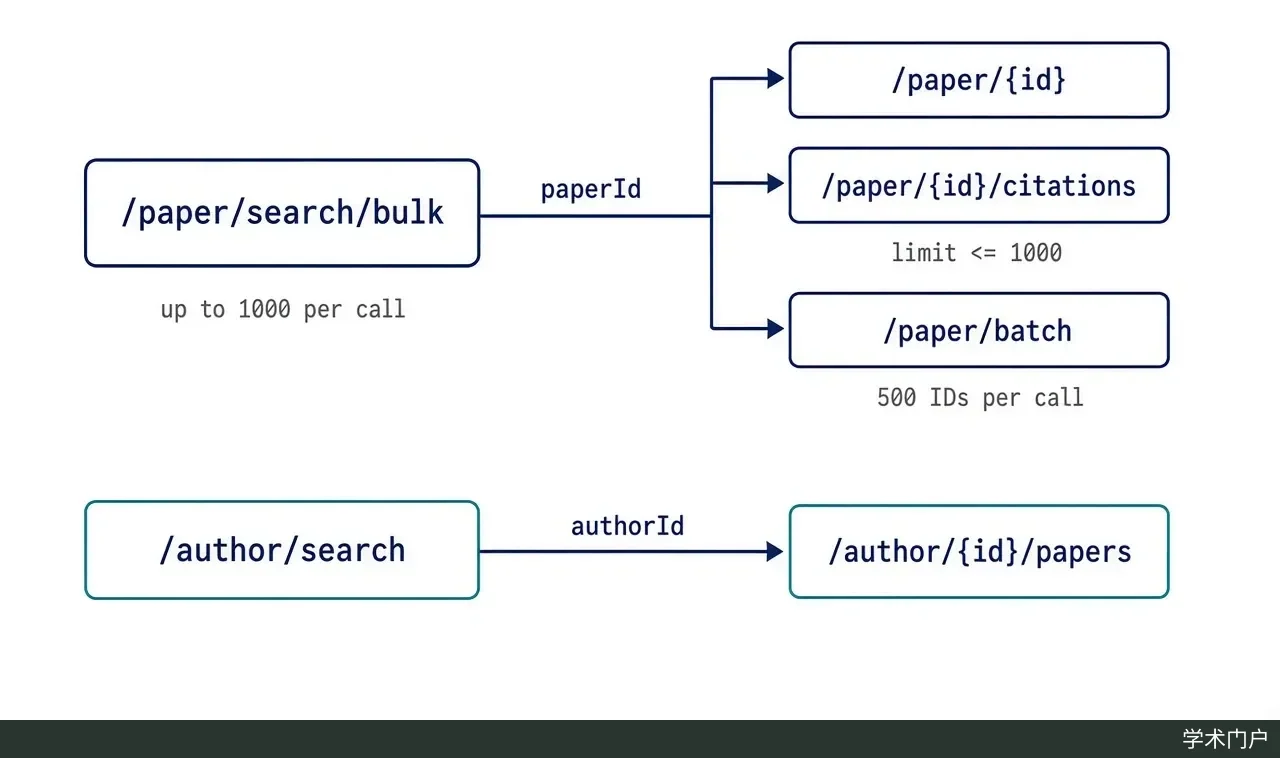
Academic Graph API 常用接口关系:批量检索返回的 paperId 可用于论文详情、引用列表和批量详情接口,作者检索返回的 authorId 可用于查作者论文;图中上限依据 Semantic Scholar API 文档(2026 年 10 月查阅)。AI 生成示意图。
示例 1:用布尔语法批量检索,并按领域、年份、类型和 PDF 筛选
curl -G "https://api.semanticscholar.org/graph/v1/paper/search/bulk" \
  -H "x-api-key: $S2_API_KEY" \
  --data-urlencode 'query="systematic review" + (screening | "active learning") -protocol' \
  --data-urlencode 'fields=title,year,publicationTypes,openAccessPdf,citationCount' \
  --data-urlencode 'year=2020-' \
  --data-urlencode 'fieldsOfStudy=Computer Science,Medicine' \
  --data-urlencode 'publicationTypes=JournalArticle,Review' \
  --data-urlencode 'openAccessPdf' \
  --data-urlencode 'sort=citationCount:desc'
这条请求在标题和摘要中查找:含短语 “systematic review”,同时含 screening 或短语 “active learning”,但不含 protocol。结果限定 2020 年及以后、计算机科学或医学、期刊论文或综述,且只要有公开 PDF 的记录,按被引次数从高到低排列。没有 key 时删掉 -H 那一行即可。文档说明,检索词会按英文做词干还原,* 匹配前缀,~N 可做拼写容错或短语近邻匹配。
判读:返回中的 total 是匹配数的估计值;每次最多返回 1000 条;如果有 token,把它作为参数加到同一请求上取下一批。批量检索不按相关度排序,也不返回嵌套的引用数据。文档还提醒,按被引次数这类会变化的字段排序时,翻页途中数据更新可能让结果错乱;要完整导出,用默认的 paperId 排序更稳妥。
示例 2:用 DOI 查单篇论文的 TLDR、高影响引用数和开放 PDF
curl "https://api.semanticscholar.org/graph/v1/paper/DOI:10.18653/v1/N18-3011?fields=title,year,venue,externalIds,citationCount,influentialCitationCount,tldr,openAccessPdf"
这里的 DOI 对应官方文档的示例论文《Construction of the Literature Graph in Semantic Scholar》(NAACL 2018)。路径中的论文 ID 也可以写成 ARXIV:2106.15928、PMID:19872477、PMCID:2323736、CorpusId:215416146,或 URL: 加 arXiv、ACL 等站点的论文链接。
判读:citationCount 是站内识别到的引用总数,influentialCitationCount 是其中被判为高影响的数量。tldr 和 openAccessPdf 都可能为空:前者受领域限制,后者只表示系统没有找到公开 PDF 链接(官方教程的示例输出里就有 openAccessPdf: null),不代表论文没有开放版本。不写 fields 时只返回 paperId 和 title。
示例 3:列出施引论文,只挑高影响或沿用方法的引用
curl "https://api.semanticscholar.org/graph/v1/paper/DOI:10.18653/v1/N18-3011/citations?fields=title,year,isInfluential,intents,contexts&limit=100"
每条结果包含施引论文(citingPaper)的标题和年份、isInfluential(是否为高影响引用)、intents(引用意图,文档示例值为 methodology)和 contexts(引用所在的原文句子)。limit 默认 100、最大 1000,用 offset 翻页。
判读:先筛出 isInfluential 为 true 的记录,再读 contexts 原句,确认对方到底怎么用了这篇论文。比起只看被引次数,这样能分清“顺带一提”和“照着做了”。意图和上下文都依赖全文,空数组不代表没有引用关系。
示例 4:批量解析 ID 清单,再查作者的论文列表
curl -X POST "https://api.semanticscholar.org/graph/v1/paper/batch?fields=title,year,externalIds,isOpenAccess,openAccessPdf" \
  -H "Content-Type: application/json" \
  -d '{"ids":["DOI:10.18653/v1/N18-3011","ARXIV:2106.15928","PMID:19872477"]}'

curl "https://api.semanticscholar.org/graph/v1/author/search?query=oren+etzioni&fields=name,affiliations,paperCount,citationCount,hIndex&limit=5"

curl "https://api.semanticscholar.org/graph/v1/author/1741101/papers?fields=title,year,venue&limit=100"
批量接口一次最多处理 500 个 ID,单次返回不超过 10 MB;fields 要写在网址参数里,不放进请求体。作者检索按姓名返回候选人列表;作者 ID 就是作者页网址末尾的那串数字,例如 1741101。
判读:同名检索常返回多个候选人(文档中检索 adam smith 的示例返回 490 位),要用 affiliations、paperCount 和代表作交叉确认,不能直接取第一条。作者论文接口同样用 offset 翻页。
结果判读与数据局限
规模方面,API 页面列出的论文数约为 2.14 亿篇,FAQ 称站内有超过 20 亿条引用(两处都没有标注统计日期)。但 FAQ 也写明,收录重点是已发表的学术论文和预印本,图书覆盖非常有限,不收专利;部分出版社不公开参考文献数据。因此 Semantic Scholar 上的被引次数和 h 指数,常常与其他网站对不上。
不少字段是模型推断出来的,使用时应把它们当线索,而不是定论:
- 领域:只对英文论文分类,按领域筛选会漏掉非英文文献;
- TLDR:限计算机科学和生物医学,属模型生成文本,可能有错;
- 高影响引用与引用意图:依赖施引论文全文,全文缺失时会被低估;
- 作者归属:由消歧模型合并,同名作者可能混在一起;
- 日期:不少记录没有精确出版日期,按日期区间筛选时会被当作当年 1 月 1 日处理,
year字段则始终存在。
检索机制上,相关度检索接口 /paper/search 最多只返回 1000 条结果,网页端又没有布尔逻辑;要做可复现的系统检索,应改用批量检索接口,并保存完整请求和检索日期。openAccessPdf 只说明系统找到了公开 PDF 链接,版本和许可要到链接页面核对;FAQ 也说明,Semantic Scholar 不能代作者或出版社授予转载许可,也不为论文中的结论背书。比较稳妥的做法是:用 Semantic Scholar 做发现和初筛,关键文献的元数据回到 DOI 页面或出版社核对;系统综述这类查全要求高的任务,再与 PubMed、Crossref 等数据库交叉检索。