论文搜到了,接下来该保留哪些?Semantic Scholar 把网页检索、引文追踪和新论文推荐接在一起,也提供可编程调用的学术图谱接口。本文用四组可复用示例说明怎样逐步筛选、判读摘要与引用信号,并厘清免费 API 的限速和覆盖边界,避免把排序靠前或有 PDF 当成证据可靠。
网页检索与逐步筛选
示例 1:先宽查,再逐项收窄。 在 Semantic Scholar 输入 retrieval augmented generation,再单独检索 "retrieval augmented generation",比较候选论文是否更贴近目标概念。网页支持引号短语,不支持布尔运算和通配符;不要直接套用其他数据库的 AND、OR 或 *。用完整术语起步,比只输入 RAG 更便于控制歧义。官网检索说明
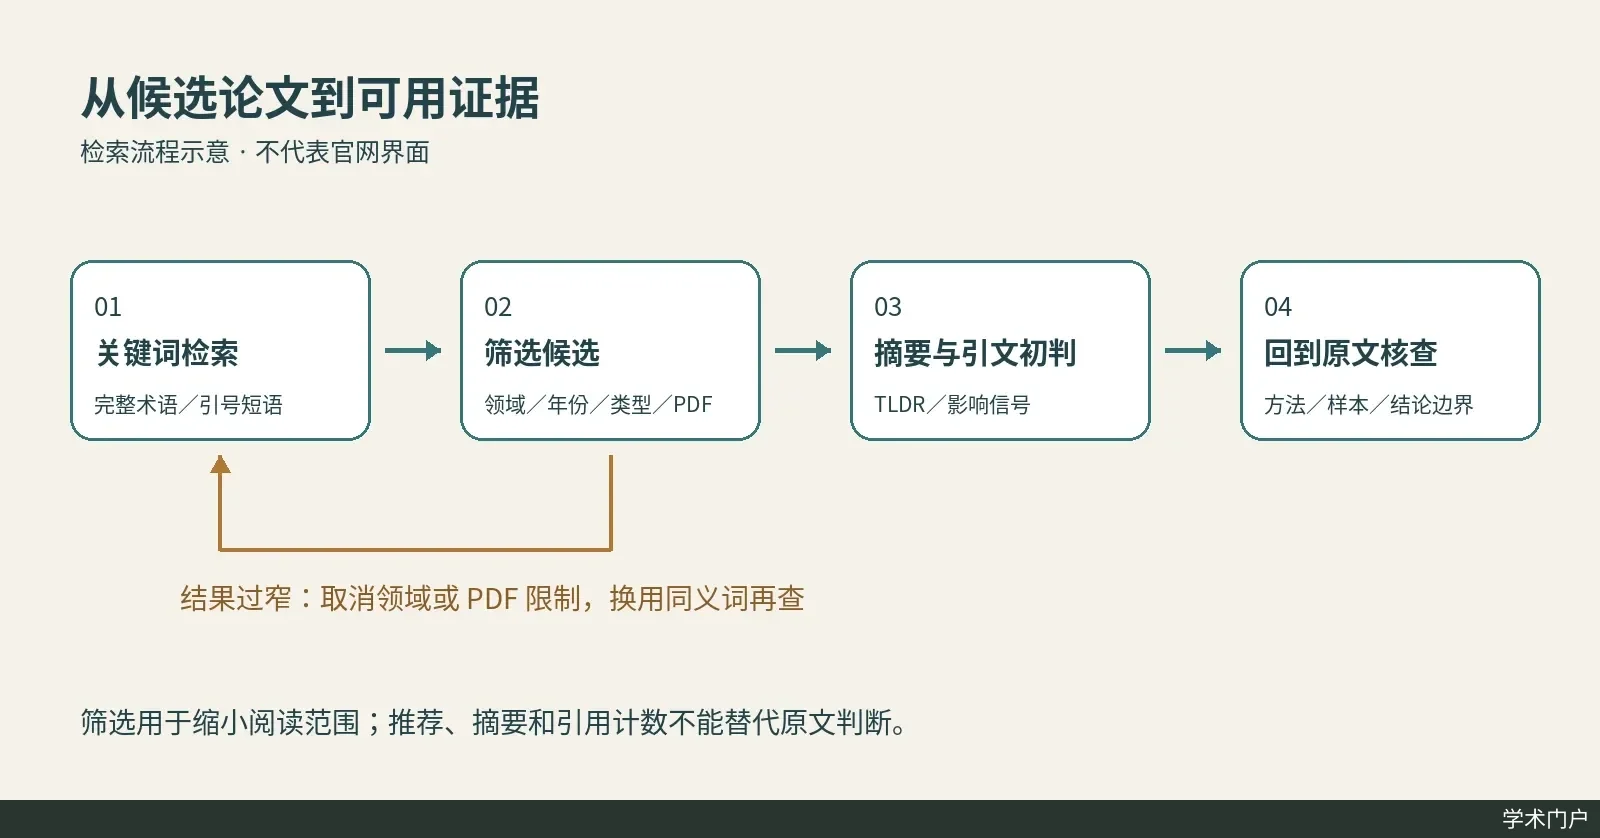
按下面顺序操作,每次只增加一项条件,方便发现是哪一步排除了论文。
| 筛选项 | 可复用设置 | 怎样判读 |
|---|---|---|
| Field of Study(领域) | 先看 Computer Science,再取消领域限制复查 | 适合排除明显无关学科;不能据此判定跨学科论文无关 |
| 日期范围 | 例如设为 2023–2026,查看近年的工作 | 这是本次检索条件,不是完整研究史;回溯基础方法时应放宽 |
| Publication Type(出版物类型) | 综述入门时选 Review;另查期刊或会议论文 | 类型用于组织阅读,不单独证明同行评审状态或方法质量 |
| PDF 可得性 | 需要马上阅读时检查结果中的 PDF 入口 | 没有 PDF 入口也应保留相关记录,再查出版商或机构馆藏 |
领域、日期和出版物类型的操作依据是官方 Search 教程。PDF 要多留一步:本次未能读取实时搜索页,官方可读教程也未确认当前 PDF 筛选按钮的名称与位置,因此不把旧版“Has PDF”界面当成已核验的现行步骤;下文用 API 的公开 PDF 筛选给出确定可查的参数。论文详情页的全文入口可跳转 PDF 或出版商,能否访问取决于来源。全文访问说明
先按相关性挑候选,再按时间看看新论文是否被漏读。保存检索词、日期、筛选条件和排除理由;取消领域与 PDF 限制后再查一遍。领域标签来自模型且限英语论文,缺摘要、标题含糊或跨学科时尤其需要人工复核。领域分类说明
摘要与引用信号的判读
打开候选论文后,先用 TLDR 判断是否值得进一步读,再核对摘要、研究对象、方法和结论。TLDR 是 AI 生成的极短摘要,官网称目前覆盖计算机科学与生物医学;没有 TLDR 不表示论文不重要。它压缩了大量背景,不能直接拿来替代原文中的限定条件。TLDR 说明
“Highly Influential Citations”关注的是被引论文对施引论文的重要影响,模型利用引用上下文等信息作出识别。它依赖施引论文全文可得性,因此未标记不能推出“没有影响”。这个标记也不能告诉你施引作者是在支持、质疑还是修正原结论。官方影响引用说明
实际阅读时,可以优先打开一篇带标记的施引论文,找到引用段落,核对它究竟沿用了方法、扩展了结果,还是只讨论了背景。总引用数用于找到值得追踪的线索,影响标记用于安排阅读顺序;是否纳入自己的论证,仍要看原文与研究问题的关系。
还要区分“没搜到”和“不存在”:官方说明其内容主要面向英语学术论文与预印本,图书覆盖有限,不包含专利。中文议题、专著传统较强的领域和专利检索都需要其他来源补充,不能用这里的结果数代表全部文献。覆盖说明
用推荐持续追踪新论文
示例 2:把已筛好的论文变成追新种子。 登录后,将相关论文保存到 Library 中一个主题清楚的文件夹,例如“检索增强生成的评估”;在该文件夹页面开启 Research Feed。后续看到无关推荐时,标记为 not relevant,看到确实相关的论文则继续保存到对应文件夹。官方说明推荐每日刷新,新建后可次日再查看。创建 Research Feed
不要把所有兴趣混在同一文件夹:将方法评估、具体应用等主题分开,是本文建议的整理方式,便于判断推荐偏向了什么。如果推荐长期偏向某个应用场景,先检查种子论文是否也集中在该场景,再补入其他方向的代表作。
Research Feeds 推荐的是平台语料中近三个月发表的论文,适合持续追新,不能替代历史文献回溯。推荐范围 同时保留独立的关键词检索:算法没有推荐某篇论文,并不是排除它的理由。
API 调用与结果整理
API 适合把候选论文整理成可复查的记录。以下示例依据官方文档编写,未执行线上实测,不提供虚构的响应或命中数量。
先分清免费访问与限速。 多数端点可以不带密钥调用;官网所写的匿名 1000 requests/second 是所有匿名用户共享的池,高峰还可能进一步限流,并非每个人可独占的额度。API key 的初始限速是所有端点合计 1 RPS,即每秒一次请求。需要持续调用时,在官方 API 页面申请密钥,通过 x-api-key 请求头发送;部分端点本就要求认证。密钥应存入环境变量,不写进公开代码。
示例 3:检索近期论文并按 token 翻页。 安装 Python 的 requests 包后运行下例;环境变量 S2_API_KEY 可选,未设置时以匿名方式请求。示例默认只取一页,确认条件合适后再调高 MAX_PAGES,避免无意发起大量下载。
import os
import time
import requests

BASE = "https://api.semanticscholar.org/graph/v1"
key = os.getenv("S2_API_KEY")
headers = {"x-api-key": key} if key else {}

def get_json(path, params):
    for attempt in range(5):
        # 单进程串行请求;如多进程共用 key,需统一调度
        time.sleep(1.1)
        r = requests.get(BASE + path, params=params,
                         headers=headers, timeout=30)
        if r.status_code == 429:
            delay = r.headers.get("Retry-After", "")
            time.sleep(float(delay) if delay.isdigit()
                       else 2 ** (attempt + 1))
            continue
        r.raise_for_status()
        return r.json()
    raise RuntimeError("持续限流,请稍后再试")

params = {
    "query": '"generative ai"',
    "year": "2023-",
    "fields": "title,url,publicationTypes,publicationDate,openAccessPdf",
}
MAX_PAGES = 1
seen = set()
first_id = None
for page in range(MAX_PAGES):
    result = get_json("/paper/search/bulk", params)
    if page == 0:
        print("估计匹配数:", result.get("total"))
    for paper in result.get("data", []):
        pid = paper["paperId"]
        if pid in seen:
            continue
        seen.add(pid)
        first_id = first_id or pid
        print(pid, paper.get("title"), paper.get("openAccessPdf"))
    token = result.get("token")
    if not token:
        break
    params = {**params, "token": token}
year=2023- 表示从 2023 年起;fields 选择返回字段,返回 openAccessPdf 字段本身不会排除没有公开 PDF 的论文。需要只看公开 PDF 时,在首次请求前加入 params["openAccessPdf"] = "";这是不接收取值的筛选参数,不写成 true。也可加入 params["publicationTypes"] = "Review" 或 params["fieldsOfStudy"] = "Computer Science",分别形成综述或领域子集,每次改条件都应重新开始分页。官方参数规范
bulk 返回的 total 是估计数,按返回的 token 续取;它用于批量匹配,不提供网页相关性排序。不要把第一页当成“最值得读”的论文名单。这里的查询端点与网页语法不同,不能相互照搬。API 教程
示例 4:沿真实 paperId 查看施引论文。 接着运行下面的代码,使用上一例实际返回的首个 ID;若没有结果就跳过,不填写猜测的 ID。
if first_id:
    citing = get_json(
        f"/paper/{first_id}/citations",
        {"fields": "title,year,contexts,intents,isInfluential",
         "limit": 10, "offset": 0},
    )
    for edge in citing.get("data", []):
        paper = edge.get("citingPaper") or {}
        print(paper.get("title"), paper.get("year"),
              edge.get("isInfluential"), edge.get("contexts"))
    print("下一批 offset:", citing.get("next"))
citingPaper 是引用目标论文的文章;contexts 是可得的引用上下文,isInfluential 是模型标记。空上下文不能解释成没有引用理由,标记也不等于对结论的赞成。此端点用 offset 分页,与 bulk 的 token 不同;如要继续,使用响应中的 next,不能将十条样本当成全部引用。施引查询规范
整理结果时,以 paperId 去重并记录查询时间、条件和页数。publicationDate、publicationTypes 或 PDF 字段为 null,表示相应数据缺失;不要补猜日期、把类型缺失写成未审稿,或把没有公开 PDF 写成没有全文。论文收录、引文提取和全文可得性都会影响覆盖,分页取完仍不等于穷尽全部研究。
遇到 429 应减速并退避,不用并发绕开限制。免费访问也受官方 API 许可约束,商业用途或超出许可范围的用途应联系官方确认;PDF 链接还需另查原文许可,公开可读不等于任意再分发。
图示说明:题图为 pushandplay 发布的 Eigenfactor: Visualizing Information Flow in Science,许可为 CC BY 2.0,仅用于说明学术信息联系,不是 Semantic Scholar 界面或本次检索结果。