
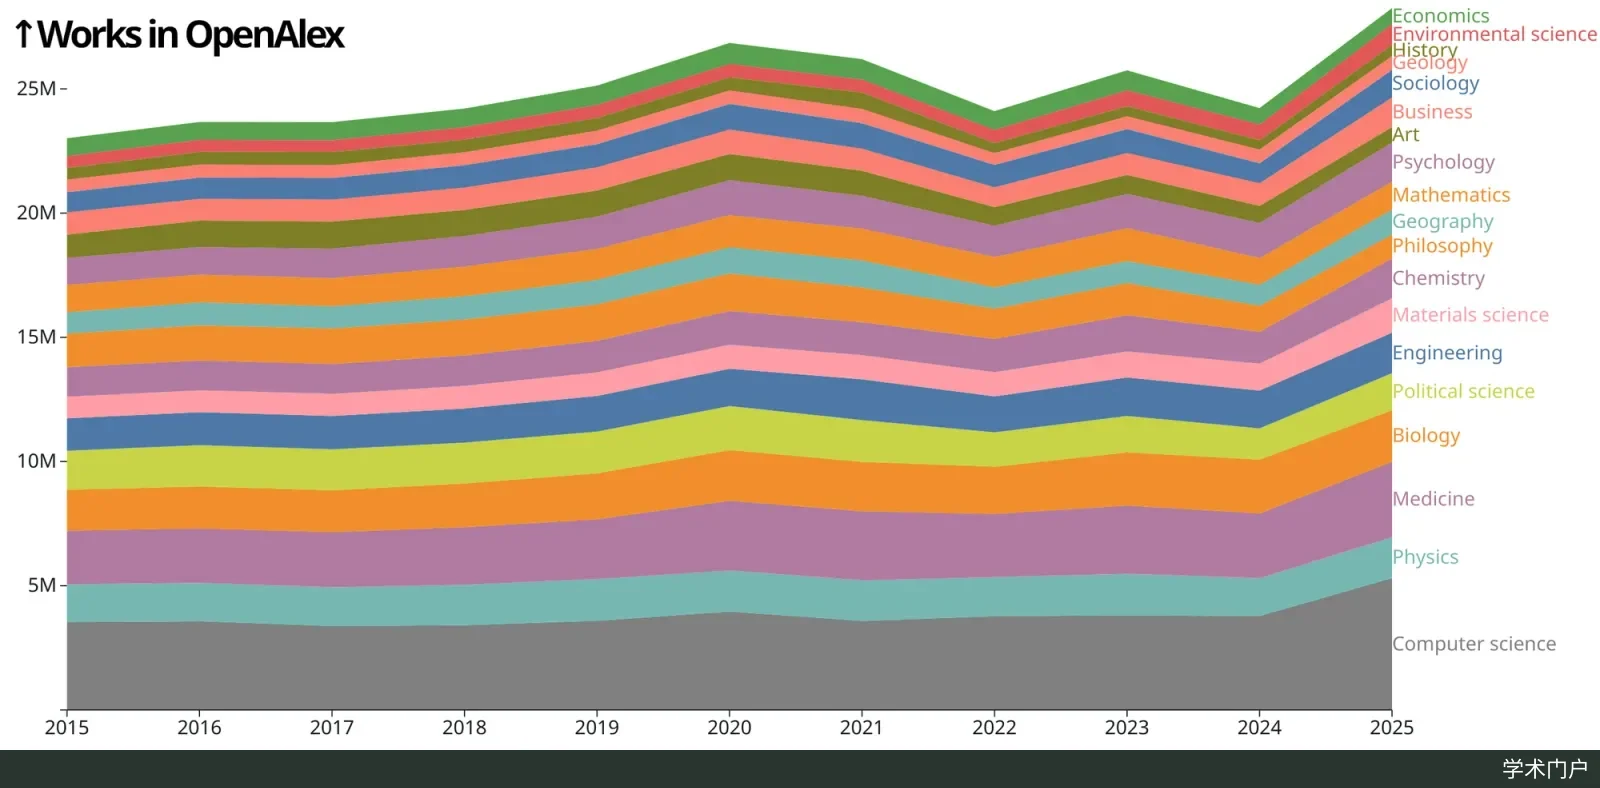
OpenAlex 是以 CC0 许可开放的学术图谱,可在 openalex.org 按作者、机构、主题、开放获取状态和年份筛选文献,也能用 API 或整库快照批量获取数据。2026 年 2 月起,API 改用免费密钥并按用量计费,原先的“礼貌池”随之取消。本文说明网页检索、API 额度与快照下载,给出三个可复用示例及判读方法,并列出它与 Scopus、Web of Science 相比的覆盖和数据质量局限。
网页端检索与筛选
在 openalex.org 的搜索框输入检索词,作品(works)默认在标题、摘要和关键词中匹配,排在最前的结果还会经过一次相关性重排;搜索框菜单可改为只查标题、查标题加摘要,或把全文也纳入范围。结果旁的筛选栏可按年份、文献类型、开放获取状态、机构等逐层收窄,每个筛选项同时显示当前结果在该字段上的分布。结果可按被引次数或日期排序,并导出为 CSV。跨字段的 OR、深层嵌套等组合在点选模式里写不出来,需要转到高级查询构建器。
作者和机构常有重名或多种写法,官方建议先确定实体 ID 再筛选,而不是直接按名字过滤。在网站搜索作者姓名,或从某篇论文点进作者名,页面网址末尾以 A 开头的编号就是作者 ID;机构 ID 以 I 开头,期刊等来源以 S 开头。已知 DOI 时,在搜索框输入 doi: 加 DOI 可直接跳到对应作品。主题筛选使用 OpenAlex 与 CWTS 合作建立的 Topics 体系,约 4,500 个主题,按领域、学科、子学科、主题四级组织;旧版 Concepts 已标记弃用、不再维护,新的检索不宜再用。
开放获取筛选沿用 OpenAlex 的宽口径:只要存在一个无需付费、无需登录即可阅读全文的网址,就算开放获取。状态分为 diamond、gold、green、hybrid、bronze 和 closed 六类,其中 diamond(不收作者费用的完全开放期刊)单列,不计入 gold。状态取决于期刊而不只是文章:同样免费可读的论文,在完全开放期刊里是 gold 或 diamond,在订阅期刊里则按有无开放许可分为 hybrid 或 bronze;出版社页面不开放、但仓储里有免费副本的是 green。ResearchGate 这类需登录的网站、SSRN 这类会弹出验证码的网站,其副本不计为开放获取位置。
网站本身也运行在同一套 API 上。匿名浏览消耗的是无密钥的每日 0.10 美元额度,按 API 返回的提示,这份额度与同一 IP 地址下的其他人共用;登录后改用个人的每日 1 美元额度。打开单条记录页面不计费,但一次网站搜索要加载结果、重排和多个分面图表,官方估算约 28 个点数,约为一次 API 检索(10 个点数)的 2.8 倍。经常在网页上检索时,最好先登录。
API 密钥、额度与数据快照
OpenAlex 的 API 规则在 2026 年初有过一次重要调整。1 月 13 日,OpenAlex 团队的 Jason Priem 在用户邮件组宣布,一个月后(2 月 13 日)起 API 调用需要密钥,同时取消“礼貌池”(polite pool)。此前在请求里附上 mailto=邮箱 即可进入限额更高的通道,公告称这一做法“从来不安全,也无法扩展”。2 月 24 日,官方博客公布按用量计费,并同步上线邻近检索、精确匹配、通配符等高级检索语法,以及测试版语义检索和全文下载。现行弃用说明写明 mailto 参数会被忽略,旧教程里附加邮箱的写法已不能提升额度。
按 2026 年 10 月 15 日更新的认证文档,免费密钥需在 openalex.org 注册账户后,于 Settings → API key 处复制,邮箱验证后才生效;调用时用 api_key= 参数或 Authorization: Bearer 请求头发送,两种方式等效。不带密钥每天有 0.10 美元额度,免费密钥每天 1 美元,均在 UTC 午夜重置。不同操作价格不同,下表按官方费用页整理;官方博客也说明,价格可能随运营成本调整。
| 操作 | 每 1,000 次费用 | 免费密钥每日约可调用 |
|---|---|---|
| 按 OpenAlex ID 或 DOI 取单条记录 | 免费 | 不限 |
列表与筛选(filter=) |
0.10 美元 | 10,000 次 |
关键词检索(search=) |
1 美元 | 1,000 次 |
检索并重排(rerank=true) |
2 美元 | 500 次 |
| 下载缓存的 PDF 全文 | 10 美元 | 100 次 |
除每日额度外还有每秒速率限制:无密钥 10 次,免费密钥或预付费 30 次,年度方案 50 次。超出额度或超速都会返回 429,其中超速造成的 429 不扣费,稍等后按指数退避重试即可。单页最多 100 条(per_page=100),普通翻页最多取到第 10,000 条,更多结果要用游标分页(cursor=*),而无密钥时游标分页只能取第一页。每次响应都带 X-RateLimit-Remaining 等响应头,返回体的 meta.cost_usd 显示本次花费,批量抓取前可先据此估算成本。
需要全库或大规模数据时,应下载快照,而不是用 API 逐页抓取。公共快照存放在 AWS S3 的 openalex 存储桶,免费下载,不需要 AWS 账户,用 AWS 命令行加 --no-sign-request 即可,例如 aws s3 sync "s3://openalex/data/jsonl" "openalex-snapshot/data/jsonl" --no-sign-request。快照有 JSON Lines(gzip 压缩)和 Parquet 两种格式,各是一份完整数据。文档给出的 2026 年 9 月数字为约 6.26 亿条记录,JSON Lines 压缩后约 745 GB(其中 works 约 615 GB),Parquet 约 770 GB,解压后达数 TB,下载前应先查看 manifest.json 中的实时大小。免费快照每季度发布一次,时间为 1、4、7、10 月的第二个星期三(UTC),2026 年第四季度版定于 10 月 14 日,下一版为 2027 年 1 月 13 日;每日快照只提供给付费方案。
快照和 API 的计数可能对不上,原因主要有两点。其一,快照包含全部作品,含“扩展语料”(旧称 XPAC),而 API 默认只查核心语料;按文档的 2026 年 9 月数字,默认约 3.27 亿条,加 corpus=all 后约 4.76 亿条。其二,快照是某一时点的版本,API 则持续更新。公共存储桶只保留当前版本,需要复现结果的研究应记录 manifest.json 的 date 字段,并自行存档所用副本。OpenAlex 元数据以 CC0 许可发布,可自由下载、共享和再利用。
三个可复用示例及结果判读
以下三个示例都可以直接粘贴到浏览器运行,把 YOUR_KEY 换成自己的密钥即可;去掉 api_key 参数也能试用,但会消耗与同网络用户共用的无密钥额度。文中数字是 2026 年 10 月 20 日不带密钥实际查询的返回结果,数据持续更新,重跑时数字会有变化。
示例一:查某位作者的全部作品
# 第 1 步:用 ORCID 解析作者 ID(单条查询,免费)
https://api.openalex.org/authors/orcid:0000-0003-1613-5981

# 第 2 步:用返回的作者 ID 列出作品,最新的在前,只取需要的字段
https://api.openalex.org/works?filter=author.id:A5048491430&sort=-publication_date&select=id,doi,display_name,publication_year,cited_by_count&per_page=100&api_key=YOUR_KEY
判读要点:先看返回的 orcid 和 last_known_institutions 是否与本人对得上。作者 ID 由算法消歧生成,档案会被合并或删除,被合并掉的 ID 直接返回 404,不会跳转到保留的档案。例如官方 API 速查页把 Heather Piwowar 的 ID 写作 A5023888391,而本文查询时按姓名检索返回的是 A5048491430(ORCID 0000-0003-1613-5981),两者不同的具体原因未知。因此每次都应现场用 ORCID 或姓名重新解析,不要从旧教程或旧代码里照抄作者 ID。怀疑档案漏收或误收时,可用 raw_author_name.search:"名 姓" 按论文署名原文核对。
示例二:某机构五年内论文的开放获取构成
# 第 1 步:用 ROR 解析机构 ID(清华大学,ROR 03cve4549)
https://api.openalex.org/institutions/ror:03cve4549

# 第 2 步:2020–2024 年该机构作品按 OA 状态分组计数
https://api.openalex.org/works?filter=institutions.id:I99065089,publication_year:2020-2024&group_by=open_access.oa_status&api_key=YOUR_KEY
判读要点:返回体里 meta.count 是命中总数,group_by 是各组计数。本文查询时总数为 118,149 篇,其中 closed 60,211、gold 20,220、green 19,243、hybrid 6,898、bronze 5,995、diamond 5,582,六组之和正好等于总数,开放获取占比约 49%。与其他报告比较“金色 OA”时要注意,OpenAlex 把 diamond 单列,口径一致时应把 gold 与 diamond 相加。meta.x_query.oql 会把请求翻译成可读的查询语句(此例为“机构恰为 I99065089,且发表于 2020 至 2024 年”),可用来核对筛选条件是否按预期解析。另外,论文要有机构隶属数据才会被计入,而对比研究发现 OpenAlex 的机构信息缺失较多;默认结果也不含扩展语料。这次分组查询花费 0.0001 美元。
示例三:关键词检索加年份、类型和 OA 筛选
# 关键词检索 + 筛选,按被引次数降序
https://api.openalex.org/works?search="systematic review" AND "large language model"&filter=publication_year:2023-2025,type:article,open_access.is_oa:true&sort=cited_by_count:desc&select=id,doi,display_name,publication_year,cited_by_count,open_access&per_page=100&api_key=YOUR_KEY

# 收窄到标题、摘要和关键词(网站默认的检索范围)
https://api.openalex.org/works?search.title_abstract_keywords="systematic review" AND "large language model"&filter=publication_year:2023-2025,type:article,open_access.is_oa:true&api_key=YOUR_KEY

# 改用 Topics:先查主题 ID,再把 Txxxxx 换成返回的主题 ID 筛选
https://api.openalex.org/topics?search=large language models
https://api.openalex.org/works?filter=topics.id:Txxxxx,publication_year:2023-2025&api_key=YOUR_KEY
判读要点:search= 的范围包括标题、摘要、全文和关键词,并会做词干化。本文查询时第一条请求返回 26,899 篇,被引最高的前三篇里有一篇是临床预测模型的报告规范 TRIPOD+AI,它只是在正文中同时出现了这两个短语,并非讨论用大模型做系统综述。要提高精确度,可改用 search.title_abstract_keywords= 或 search.title_and_abstract=;官方文档以 antimicrobial resistance 为例,前者命中 241,167 篇,后者 118,920 篇。按被引次数排序会让发表早、引用累积多的论文靠前,查新时宜改回默认的相关性排序。cited_by_count 是 OpenAlex 自己的统计,不能与 Scopus 或 Web of Science 的被引数直接比较。每次检索花费 0.001 美元,是列表筛选的 10 倍;通配符需改用 search.exact,布尔式过长、整个网址超过约 4 KB 时要拆成几条分别请求再合并结果。第二、三组请求是按文档写出的用法,本文未实测,因为测试中无密钥额度已经用完。
与 Scopus 和 Web of Science 的差异
Alperin 等人与 OpenAlex 团队合作,在 2024 年提交给 STI 会议的预印本中把 OpenAlex 与 Scopus 逐项对比。结论是 OpenAlex 的收录范围是 Scopus 的超集,两库在所比较的各项计数上排序高度相关;限定在 Scopus 收录期刊范围内时,OpenAlex 可作为国家层面分析的可靠替代。但相当多作品缺少作者隶属信息;作品语言由算法根据标题和摘要推断,按语言统计的结果与 Scopus 一致性最低。
Culbert 等人 2025 年 4 月发表于 Scientometrics 的研究比较了三库的参考文献覆盖。直接平均时,OpenAlex 每条记录能对应到库内记录的参考文献只有 7.6 条,Web of Science 和 Scopus 分别为 16.9 条和 18.7 条;但限定在三库共同收录、经过清洗的 1,680 万篇 2015–2022 年文献后,OpenAlex 与两者相当。作者据此推断,OpenAlex 收录了大量参考文献很短、两家商业库没有收录的记录。按期刊比较其他元数据时,OpenAlex 的 ORCID 更多、摘要更少,开放获取标注数量相近。
Alonso-Álvarez 与 van Eck 2025 年在 Quantitative Science Studies 发表的研究以非洲期刊论文为样本,OpenAlex 数据取自 2023 年 11 月的快照。OpenAlex 收录的非洲出版物最多,出版物和作者信息的完整度与准确度较高,ORCID 覆盖率为 44%,Scopus 为 22%,Web of Science 为 10%;但机构隶属、参考文献和资助信息缺失或不完整的比例较高,文献类型也比两家商业库划分得粗。同时被 Scopus 或 Web of Science 收录的论文,在 OpenAlex 中的元数据明显更完整、更准确。
这三项研究使用的都是 2023–2024 年的数据,此后 OpenAlex 在 2025 年切换到新的 Walden 系统,数据和字段仍在调整,本文未找到针对当前版本的新评估,上述结论是否依然成立尚不清楚。实际使用时可以这样分工:找文献、看领域或国家的分布趋势,OpenAlex 的覆盖面是优势;做机构评估、引文指标或资助分析时,应抽样核对原文,并说明它与商业库在收录口径上的差别。无论哪种用途,报告里都应写明查询日期、完整的 API 请求或快照 manifest.json 的日期,便于他人复现。