
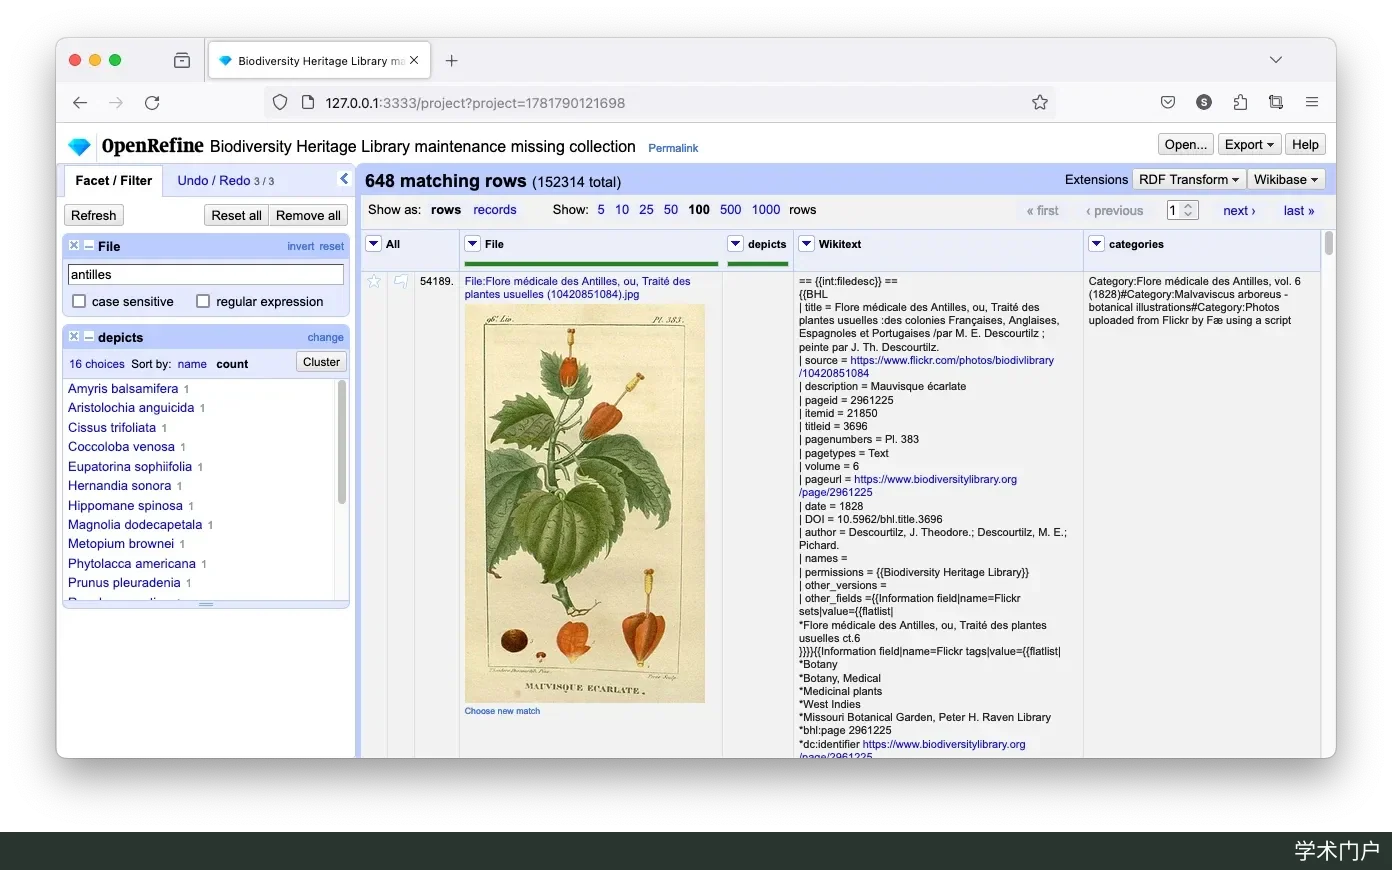
OpenRefine 中的一个维基共享资源项目界面。图:Sandra Fauconnier,来源 Wikimedia Commons,CC BY 4.0。

OpenRefine 是一款免费开源的数据清洗工具,在本机运行、通过浏览器操作,数据留在自己电脑上。它适合整理问卷、文献题录、馆藏目录这类取值混乱的表格:用分面找出不一致,用聚类合并相似写法,用 GREL 表达式批量改写,再与 Wikidata 等外部库对接,并把操作历史导出复用。本文为资料核验,未安装实测。
项目前身为 Google Refine,源代码托管在 GitHub 的 OpenRefine/OpenRefine 仓库,许可证为 BSD-3-Clause(LICENSE.txt 中同时保留 2010 年 Google Inc. 与 OpenRefine 贡献者的版权声明)。截至本文核验,最新稳定版为 3.10.1,GitHub 发布时间为 2026 年 3 月 4 日(UTC);发布说明称它与 2 月 26 日发布的 3.10.0 功能相同,只是 Mac 安装包完成了公证。官方提供 Windows、Mac、Linux 安装包,运行需要 Java,其中 Mac 版和 Windows 的“with Java”包已内置。程序启动后在本机以小型网页服务运行,基本功能无需联网;只有从网络导入数据、调用对接服务或向网络导出时才需要联网。
对研究者而言,OpenRefine 的主要价值在于把手工改表格变成一串可查看、可撤销、可重放的操作,日后能说清数据是怎样从原始记录变成分析用表的。下面按研究数据整理的常见环节,介绍官方文档描述的功能和使用边界。
分面筛选与聚类合并
分面是 OpenRefine 浏览数据的基本方式:对某列建立文本分面后,侧栏会列出该列所有不同取值及其行数,点选即可只看这些行,也可以反向排除。此外还有数值、时间线、散点图分面,以及重复值、空值、文本长度等定制分面,适合排查“同一机构有五种写法”“日期列混入文字”之类的问题。官方文档提醒,多数导出格式只导出当前筛选后可见的行,导出前要先确认分面状态。
发现不一致后,可以用“聚类并编辑”合并相似值。界面提供 6 种键碰撞方法(fingerprint、n-gram fingerprint 和四种语音算法)与 2 种最近邻方法(Levenshtein、PPM)。键碰撞速度快,官方称可在数秒内处理数百万个单元格;最近邻方法更慢,需要设置半径和分块参数。每组合并建议都要人工确认,只有被批准的合并才会改动数据。四种语音算法分别面向英语、德语和斯拉夫语/意第绪语名称,官方文档没有说明对中文数据的效果。
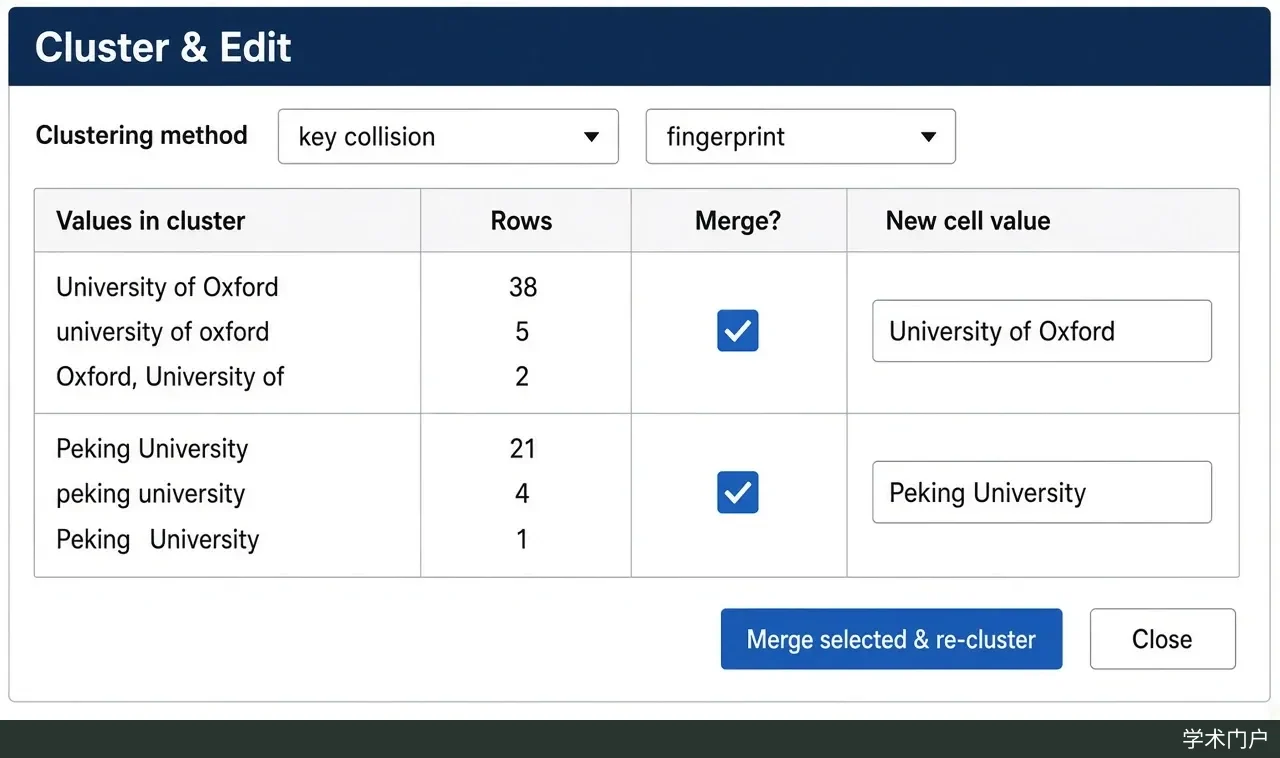
AI 生成示意图:OpenRefine“聚类并编辑”窗口的大致布局,界面文字与数据均为示意,不是真实截图。
GREL 表达式与 Wikidata 对接
需要批量改写时,可以在“转换”“基于此列添加列”或定制分面里写表达式。默认语言是 GREL(General Refine Expression Language),安装包还附带 Jython 和 Clojure。例如 value.replace(/\s+/, " ") 把连续空白合并成一个空格,value.split(" ")[1] 取空格分隔后的第二段。与电子表格公式不同,GREL 转换是一次性操作,结果直接写入单元格而不保留公式;表达式窗口会先预览前几行的结果,确认后再执行。
对接(reconciliation)是把表中名称与外部数据库的实体匹配,例如把机构名、地名或人名对应到 Wikidata 条目。安装包内置 Wikidata 对接服务,也可添加其他符合 Reconciliation Service API 的服务,如 VIAF。这一过程是半自动的:把握大的结果直接标为匹配,其余单元格列出候选项及得分,需要人工挑选;也可以用得分分面筛出高分项,再批量接受最佳候选。匹配默认基于字符串检索,拼写和空格都会影响结果,所以官方建议先清理、聚类再对接,并先用小批量试跑。匹配完成后,还能从 Wikidata 拉取更多属性补进表格。这一步需要联网调用外部服务。
操作历史的导出与复用
项目从创建起就记录每一步改动,在“撤销/重做”面板里可以回到任一历史状态;历史随项目保存,退出程序后仍在。点击“提取”可把选中的操作导出为 JSON,到另一个项目里用“应用”粘贴执行。对于格式相同的多批数据或多轮采集,这意味着同一套清洗步骤可以重复使用,JSON 也可以作为数据处理记录留档。不过并非所有操作都能提取,例如对单个单元格的手动编辑就无法重放;聚类这类需要人工判断的功能也不能无人值守地运行。另外,回退到早期状态后再做新操作,之后的历史会被清除。
数据规模与协作局限
OpenRefine 的运行依赖可用内存,默认分配 1 GB。官方把超过一百万个单元格、输入文件超过 50 MB,或记录模式下每条记录超过 50 行视为“大”数据集,建议预先调高内存上限,并在导入时关闭自动解析数字和日期;导入大文件时也可能耗尽内存、导入无法完成。协作方面,它按单用户桌面程序设计:官方 FAQ 说明它没有为多用户场景内置安全机制,数据模型不在用户之间共享,多人同时操作可能互相覆盖;如要部署给他人访问,只能自担风险并借助代理。多人分工时,可以考虑各自清洗,再交换导出的操作 JSON 或结果文件。