
Hindsight 是 Vectorize 开发的开源智能体记忆系统,通过 retain、recall、reflect 三项操作,保存、检索和整理智能体在多次会话中积累的信息。2026 年 10 月 13 日发布的 v1.0.0 收紧了按标签限定访问范围时的权限检查,并修复了多项编程智能体集成问题。本文为资料核验,未安装实测。
项目定位与工作方式
项目托管在 GitHub 的 vectorize-io/hindsight 仓库(github.com/vectorize-io/hindsight),官方文档位于 hindsight.vectorize.io。仓库 LICENSE 为 MIT 许可证,版权方为 Vectorize AI, Inc.。项目方另发表了技术论文《Hindsight is 20/20: Building Agent Memory that Retains, Recalls, and Reflects》(arXiv:2512.12818),作者来自 Vectorize.io、《华盛顿邮报》和弗吉尼亚理工大学。[1,2,5]
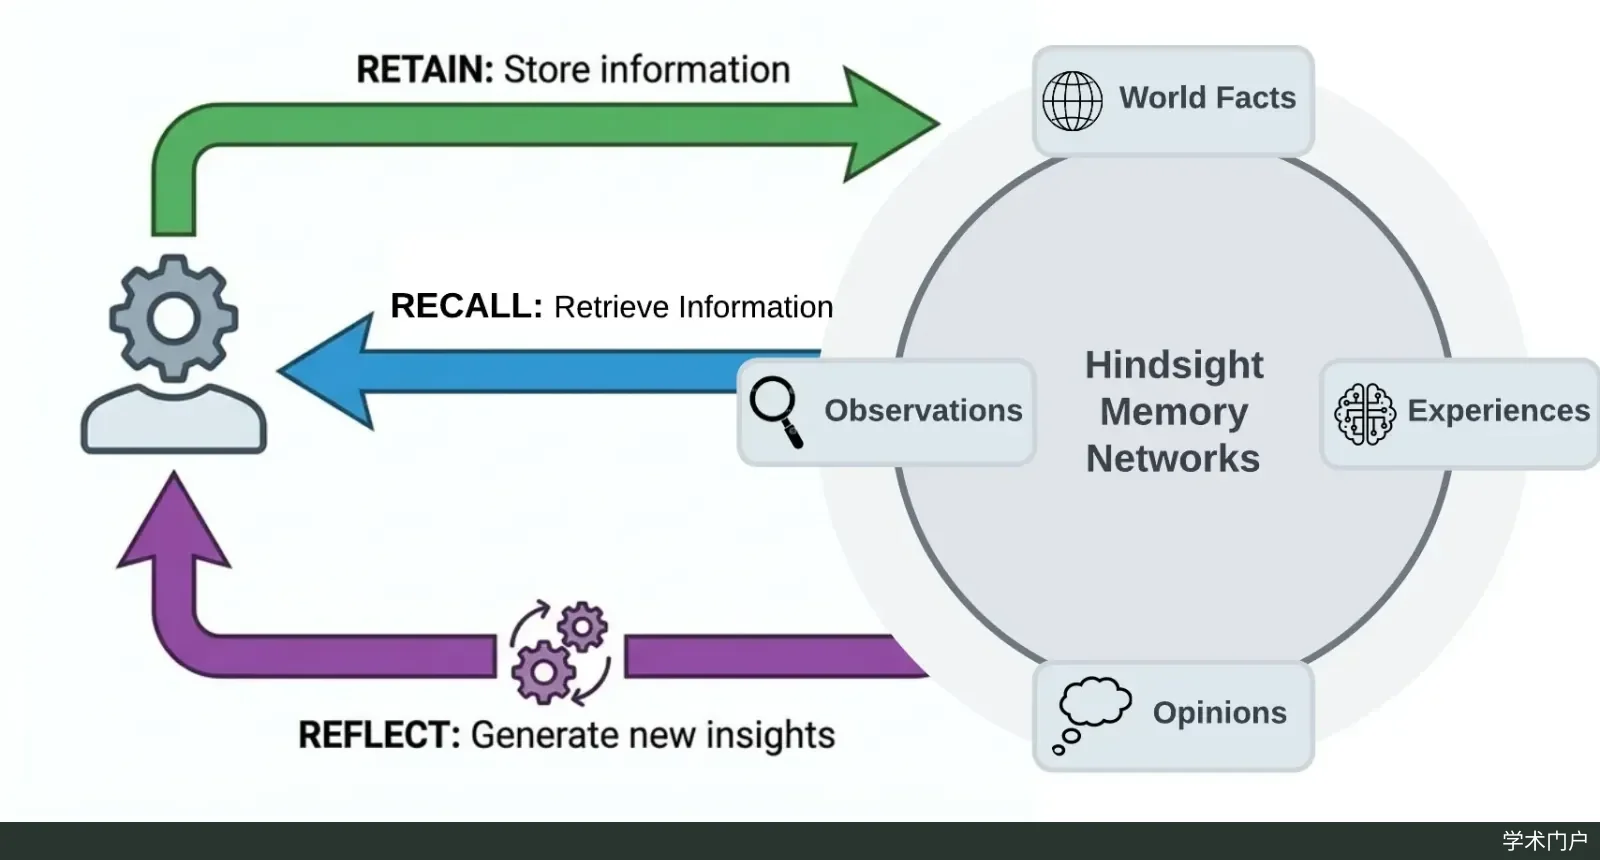
记忆存放在“记忆库”(bank)中,一个记忆库对应一个用户、一个智能体或一个项目,库与库之间相互隔离。三项核心操作的分工如下:[1]
- retain(保存):调用大语言模型从输入内容中抽取关键事实、时间信息、实体及其关系,写入记忆库。
- recall(检索):并行使用语义向量、BM25 关键词、实体/时间/因果关联图和时间范围过滤四种策略,合并结果后再用交叉编码器重排序,按 token 上限截取。
- reflect(反思):对已有记忆做更深入的分析,回答需要推理而不只是查找的问题。
记忆分为世界事实、智能体自身经历、观察(observation)和心智模型(mental model)几类。观察是后台把相关事实合并后形成的判断,附带原文引语作为证据,新证据到来时会被加强、削弱或补充,而不是直接覆盖。心智模型可以理解为对某个固定问题持续更新的答案;其中的“知识页”可以导出为普通 Markdown 文件。[1]
部署方式包括 Docker(官方推荐)、pip install hindsight-api、Kubernetes Helm,以及无需单独起服务的 Python 嵌入式包 hindsight-all;存储使用 PostgreSQL + pgvector 或 Oracle 数据库。README 称可接入 25 个以上的大模型服务,其中包括 Ollama、LM Studio、llama.cpp 等本地方案。客户端有 Python、Node.js、Go、命令行和 REST API,每个记忆库还自带一个 MCP 端点。[1]
v1.0.0 的主要变化
v1.0.0 于 2026 年 10 月 13 日(UTC)发布在 GitHub Releases,上一版是 10 月 8 日的 v0.10.3;截至 2026 年 10 月 20 日核对,它是 Releases 页面上的最新版本。[3,4] 虽然主版本号升到 1,官方更新日志中核心部分(API、命令行与控制台)列出的是一项破坏性变更、一项改进和若干缺陷修复,没有单列新功能:[4]
- 权限收紧(破坏性变更):只被授权访问部分标签的 API 调用方,不能再调用会返回整个记忆库数据的操作。v0.10.3 刚为共享记忆库加入按调用方划分的标签权限,这一改动补上了其中的越权途径。
- 可观测性:各项记忆操作统一输出模型服务的追踪数据。
- 缺陷修复:存储暂时不可用时返回 503 和 Retry-After,而不是报内部错误;正确处理内容本身说明“无事实可存”的 retain 请求;向新建文档追加的 JSON 数组合并为一个数组;命令行和生成的客户端兼容新增的返回字段与枚举值;命令行导出未完成时不再无限轮询。
同一版本的发布说明还列出了一批集成相关的修复:Claude Code 集成的内容分块丢失和时间戳问题,编程智能体在长提示词下的记忆注入和首次检索为空的问题,Codex 启动阶段等场景下会话记录保存不完整的问题,以及 Windows 下的钩子问题。OpenClaw 插件现在可以注册为 OpenClaw 的原生记忆提供者,同时移除了 agent-sdk 包和 agent_knowledge_* 系列工具。官方说明各集成按自己的节奏发版、另有更新日志,具体插件版本应到对应集成页面查看。[3,4]
一项研究往往要持续数月:数据清洗规则改了几轮、哪些分析路线已经证明走不通、某个参数为什么这样设,这些信息散落在笔记、聊天记录和提交历史里。借助 AI 助手工作时,每开一次新会话通常都要重新交代背景。Hindsight 针对的就是这类跨会话的连续性问题。下面依据官方 README 和发布说明,介绍它在科研中可能的用途和需要注意的边界。
科研场景中的用途
以下是依据官方文档整理的适用场景,并非实测结论:[1]
- 为长期课题建立项目记忆:每个课题使用一个记忆库,把分析决定、排除样本的理由、失败的尝试等写入。例如第一次会话中决定剔除作答时间过短的问卷,几周后的新会话可以检索到这条决定和当时的理由,不必重新讨论。recall 支持按时间提问,如“6 月发生了什么”,适合回顾一段时期的工作。
- 维护分析代码的编程智能体:官方的编程智能体插件会根据 git 历史和以往会话自动为每个代码仓库建立记忆库,在智能体开始工作时注入,支持 Claude Code、Codex CLI、Cursor CLI、GitHub Copilot CLI 等工具。课题组用这些工具维护分析脚本时,可以减少重复说明项目约定。
- 把固定问题的答案沉淀成文档:心智模型和知识页可以针对“本项目的数据清洗约定有哪些”这类问题持续更新答案,并导出为 Markdown,便于人工阅读和存档。
- 中文资料:README 说明会保留输入语言,中文事实和人名不会被转写成拼音或英文。
- 研究智能体记忆本身:有论文、开源代码和公开的评测页面,适合作为对照实现阅读和复现。[5]
局限与注意事项
- 未经实测:本文为资料核验,未安装实测,功能描述均来自 README、更新日志和发布说明。
- 记忆不等于事实:保存的内容由大语言模型抽取和归纳,可能出错或遗漏;观察和心智模型是系统形成的判断,会随新输入变化。早期记错的内容如果不纠正,可能在后续会话中被反复引用。科研中应把记忆当作线索,关键结论回到原始数据、文献、实验日志和代码版本核对。
- 数据去向:retain 和 reflect 都要调用大语言模型,使用云端模型服务时,写入的内容会发送给服务商;编程智能体插件会自动读取 git 历史和会话记录。涉及未公开数据、受试者信息或保密材料时,应先确认数据流向,或改用本地模型。README 提到可按记忆库开启的 Memory Defense,能按 45 种模式扫描密钥和个人信息并脱敏或拦截,但它需要主动开启。[1]
- 评测数字的来源:README 称 Hindsight 是“测试过的最准确的智能体记忆系统”,论文报告在 LongMemEval 上最高 91.4%、在 LoCoMo 上最高 89.61%。这些结果由项目方发布;README 所说的复现方弗吉尼亚理工大学和《华盛顿邮报》的研究者也是论文合作者,不能视为完全独立的验证。[1,5]
- 部署成本:自托管需要运行服务、PostgreSQL 数据库,并配置大模型服务。README 自己也说明,对 n8n 一类简单工作流,Hindsight 可能大材小用。[1]
- 升级与版本:v1.0.0 含破坏性变更,OpenClaw 插件也删除了部分工具;各集成独立发版。已有部署升级前应阅读发布说明,科研项目宜固定版本号。[3,4]
- 开源范围:MIT 许可证覆盖的是仓库代码;官方另有按用量计费的托管服务 Hindsight Cloud,两者需要区分。[1,2]
参考文献
[1] vectorize-io/hindsight GitHub 仓库与 README [2] 仓库 LICENSE(MIT) [3] Hindsight v1.0.0 发布说明,2026-10-13 [4] Hindsight 官方更新日志(Changelog) [5] Latimer C, Boschi N, Neeser A, et al. Hindsight is 20/20: Building Agent Memory that Retains, Recalls, and Reflects. arXiv:2512.12818
除发布说明外,上述页面为滚动更新内容,均按 2026 年 10 月 20 日核对时的内容引用。