
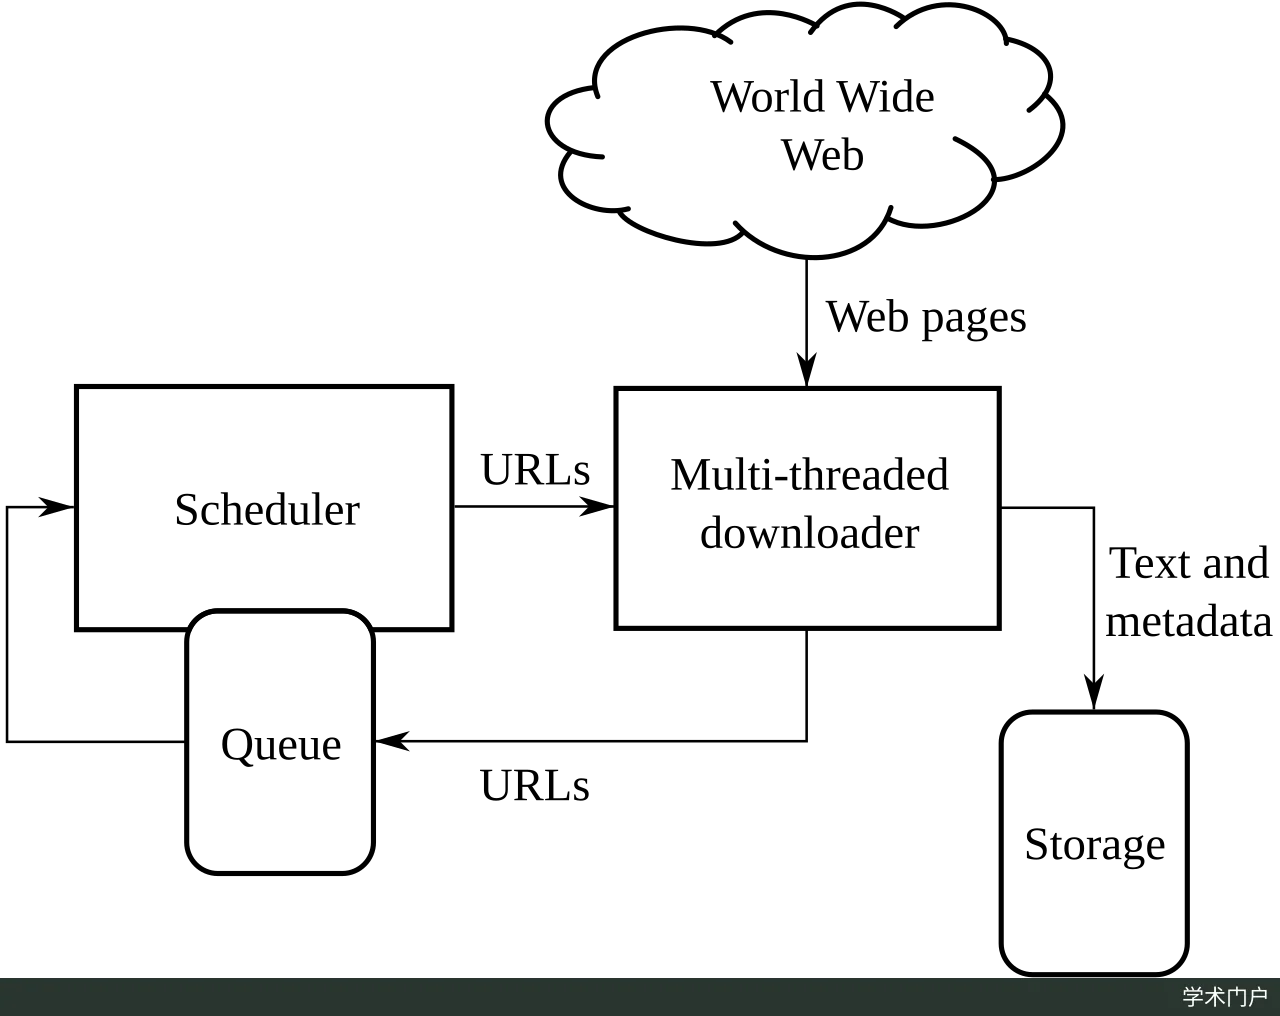
通用网页爬虫的基本架构:调度器管理待抓取网址队列,下载器抓取网页并把新链接送回队列。此图说明一般原理,并非 Crawl4AI 的实际结构。图:dnet,据 ChaTo(Carlos Castillo)原图绘制,来源 Wikimedia Commons,CC BY-SA 3.0。

Crawl4AI 是一个开源 Python 网页爬虫框架,能用浏览器渲染动态网页,把内容转成适合大语言模型读取的 Markdown 或结构化 JSON,适合批量整理公开网页资料。2026 年 10 月 14 日发布的 0.9.5 是一次安全更新,修复了自托管 Docker 服务端的六个漏洞,并新增默认关闭的深度爬取选项。本文为资料核验,未安装实测。
项目源代码托管在 GitHub 的 unclecode/crawl4ai 仓库(github.com/unclecode/crawl4ai),主要语言为 Python。GitHub 识别的许可证为 Apache License 2.0,但仓库 LICENSE 文件在 Apache 2.0 条款之后另附一段“署名要求”:公开分发、发表或使用该软件及其衍生作品时,须注明软件来自 UncleCode 的 Crawl4AI 项目,论文、博客等出版物可放在致谢或脚注中。截至本文核验(2026 年 10 月 20 日),GitHub Releases 标记的最新版为 v0.9.5,发布时间为 2026 年 10 月 14 日(UTC),可通过 pip install crawl4ai==0.9.5 或 Docker 镜像 unclecode/crawl4ai:0.9.5 获取。开源版有两种用法:在自己的 Python 程序中作为库调用,或用 Docker 自建服务端,对外提供 REST 接口和 MCP 接口,供其他程序或 AI 智能体调用。
对需要从公开网页收集资料的研究者来说,Crawl4AI 的作用是把“打开网页、等待加载、复制正文、整理格式”这类重复劳动交给程序,输出格式统一的文本,便于后续人工阅读、编码分析或交给大语言模型处理。下面依据官方文档和更新日志,介绍它适合的采集场景、0.9.5 的具体改动和使用边界。
主要功能与深度爬取
README 列出的核心能力包括:用 Chromium、Firefox 或 WebKit 浏览器加载页面,执行 JavaScript、等待指定元素出现、滚动整页以加载无限滚动内容和懒加载图片;把页面转成保留标题、列表、表格和代码块的 Markdown,可用过滤器去掉导航栏、页脚等模板内容,并把页面链接整理成编号引用列表;用 CSS/XPath 规则,或接入大语言模型,把页面字段抽取成 JSON;对页面截图或导出 PDF。放到科研工作中,它可用于整理一批会议网站的征稿信息、课题组主页的成果列表、机构公开发布的政策文件,或为检索增强生成(RAG)准备语料。
如果资料分散在同一网站的多级栏目中,可以使用深度爬取:从入口页出发沿链接继续抓取,策略有广度优先(BFS)、深度优先(DFS)和按相关性评分排序的 BestFirst 三种。max_depth 限制向下的层数,max_pages 限制总页数,include_external=False 把抓取限定在同一域名内,还可以配合 URL 过滤器和评分器使用。官方文档提醒,max_depth 大于 3 时抓取量可能成倍增长,建议用 max_pages 设置硬上限;该参数不设置时默认不限页数。
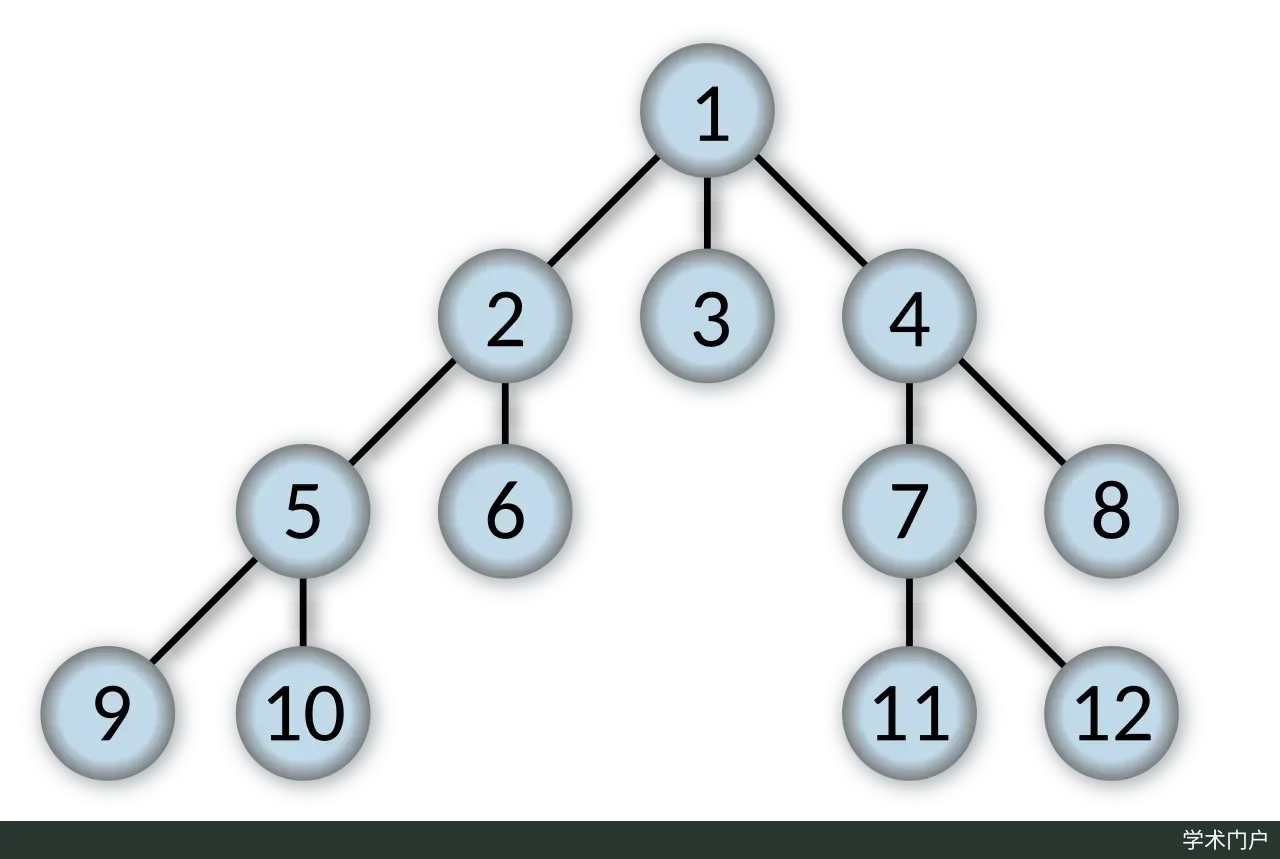
广度优先搜索(BFS)的节点展开顺序:先访问同一层的全部节点,再进入下一层。按广度优先策略深度爬取时,可以把根节点理解为入口页,下层节点为链接指向的页面。图:Alexander Drichel,来源 Wikimedia Commons,CC BY 3.0。

0.9.5 版本的改动
CHANGELOG 把 0.9.5 定位为安全版本,修复的六个问题都出在 Docker 服务端处理不可信请求内容的环节,对应的 GitHub 安全公告于 10 月 15 日公开。具体包括:缓存新鲜度检查绕过出口代理,构成盲 SSRF(服务器端请求伪造);css_selector 和 wait_for 参数可向抓取页面注入 JavaScript;调用方可让 CosineStrategy 下载并加载任意 Hugging Face 模型,在 PyTorch 低于 2.6 时可能借恶意权重文件执行代码,这是六项中唯一评为高危的一项,默认镜像未安装 PyTorch,不受影响;调用方提交的正则表达式可引发 ReDoS,一个请求就能让整个服务停顿;延迟类参数没有上限,现在限制为 60 秒;默认启动参数带有 --ignore-certificate-errors,使证书校验设置失效,现已移除。官方建议自托管 Docker 服务端的用户升级。库用户没有破坏性变更,Docker 服务端则会以 400 错误拒绝不可信请求中的上述字段。
功能方面,Docker 服务端新增可选的深度爬取:设置环境变量 CRAWL4AI_ALLOW_DEEP_CRAWL=true 后,请求才能指定 BFS、DFS 或 BestFirst 策略,页数和深度上限由 config.yml 中的 limits.max_pages 与 limits.max_depth 决定,每个策略最多使用 20 个过滤器和评分器,流式深度爬取设有截止时间;该功能默认关闭。缺陷修复包括:BFS 把已排队的下一层链接计入 max_pages,不再出现设定 50 页却抓取数百页的情况;复用的策略在新一轮运行时会重置页数预算;失败结果中的 links 和 media 字段保持统一结构;通过 SSE 连接 MCP 时先处理初始化请求。另外,这一版在安装和首次运行时会显示开发方云服务的提示,可用 CRAWL4AI_NO_CLOUD_NOTICE=1 关闭。
局限与注意事项
自建服务端的安全维护需要持续投入。仓库安全公告页显示,2026 年 8 月 31 日、9 月 23 日和 10 月 15 日先后公开了涉及 Docker 服务端的安全公告,CHANGELOG 中 0.9.4 和 0.9.5 都被定位为安全版本。README 称自建服务端的所有接口默认需要访问令牌 CRAWL4AI_API_TOKEN。如果把服务开放给他人或 AI 智能体调用,应及时升级、妥善保管令牌,并避免让爬虫服务直接接触内网资源和敏感凭证。
部分默认值偏宽松。参数文档显示,check_robots_txt 默认关闭,也就是默认不检查网站的 robots.txt;BrowserConfig 的 ignore_https_errors 默认为 True,证书无效时仍会继续抓取。用于正式研究时,宜主动开启 robots.txt 检查、关闭忽略证书错误,并控制请求频率。工具本身也不解决合规问题,网站服务条款、版权、个人信息保护和伦理审查要求仍需研究者自行确认。此外,运行需要安装浏览器组件,自建服务端还涉及 Docker 部署与维护,对没有编程基础的用户有一定门槛。
如果在论文中使用 Crawl4AI 采集数据,按 LICENSE 中的署名要求,应在致谢或脚注里注明软件来自 UncleCode 的 Crawl4AI 项目,并附上仓库地址。