
Co-Researcher 是采用 MIT 许可证的开源学术研究插件,可装入 Claude Code、Codex 等 AI 助手,用于文献综述、同行评议和研究设计。2026 年 10 月 15 日发布的 v2.8.2 为假设检验加入操纵检查,避免把实验未触发机制造成的空结果当作反证。本文为资料核验,未安装实测。
项目定位与组成
项目托管在 GitHub 的 poemswe/co-researcher 仓库(github.com/poemswe/co-researcher),README 与仓库许可证信息均标注为 MIT。[1]
README 把它定位为面向 Claude Code、Gemini CLI、OpenAI Codex 和 OpenCode 的学术研究插件,在用户已经在用的 AI 助手里完成文献综述、系统综述、同行评议和引用核查。插件提供 /research、/analyze、/review 三个命令(Codex 中用 $ 前缀),其他任务用自然语言描述后,由对应的技能自动启动。目前共 15 个技能,覆盖文献综述、PRISMA 系统综述、研究方法、假设检验、定量分析、质性研究、伦理审查、基金申请和学术写作等环节。[1]
文献检索直接调用 OpenAlex、arXiv 和 Europe PMC。verify_citations.py 把参考文献逐条对照 OpenAlex、Europe PMC 和 Crossref,标出不匹配、查不到或已撤稿的条目。文献综述交付前,Agent 要运行不依赖模型的校验脚本 validate_review.py:每段引文必须出现在原文中,每条引用只能对应一篇已筛选的文献,论断里的数字必须出现在对应引文里。校验不通过时 Agent 最多有三轮修复机会,仍未通过的稿件会标为 INVALID EVIDENCE 并列出问题。[1]
在 Claude Code 中可用 /plugin marketplace add poemswe/co-researcher 后再 /plugin install co-researcher 安装,其他平台的安装方式见 README。检索与核查脚本通过 uv 运行。[1]
v2.8.2 更新内容
v2.8.2 于 2026 年 10 月 15 日(UTC)在 GitHub Releases 发布,对应提交 ef3085a。主要改动来自贡献者 davdittrich 提交的 PR #63,随后由维护者的版本号更新 PR #64 发布。仓库没有单独的 CHANGELOG 文件,以下依据发布说明、两个 PR 页面和该版本的技能文件整理。[2,3,4,5]
-
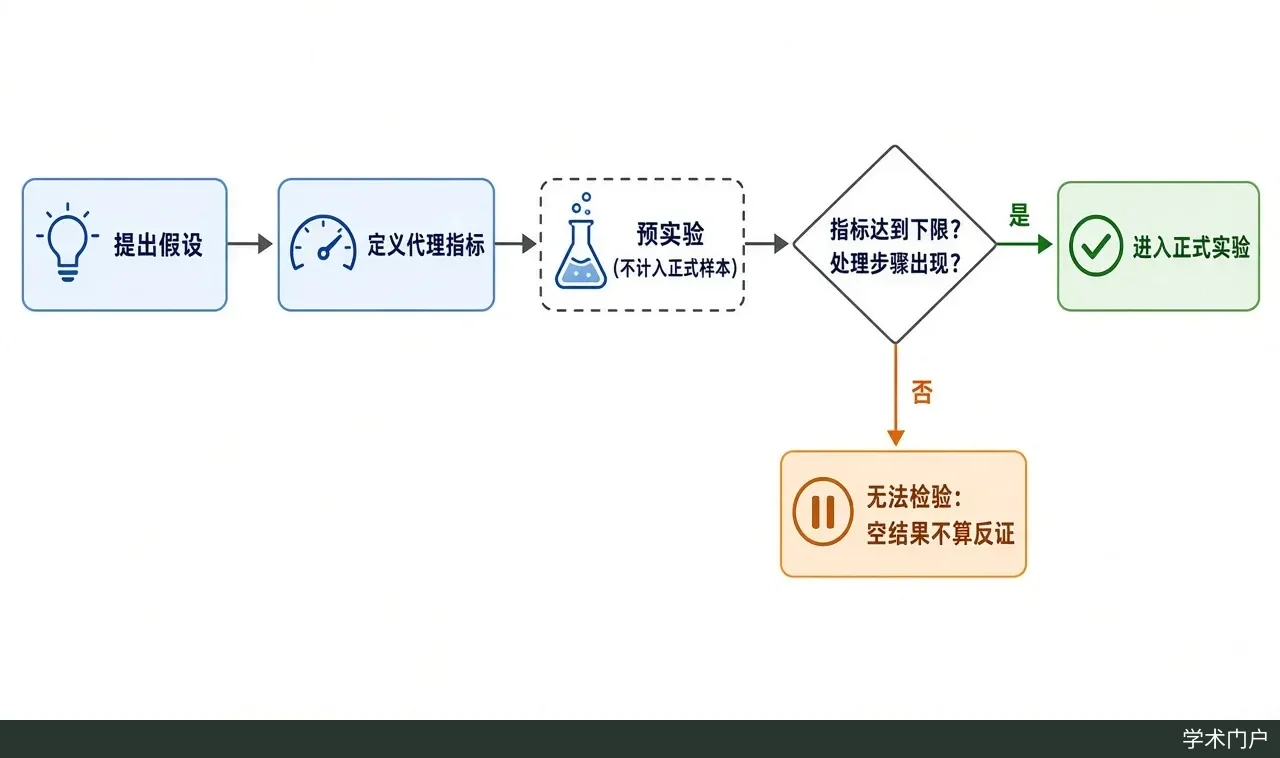
新增操纵检查(Manipulation Check):假设检验技能的流程由 6 步变为 7 步,新的第 5 步要求在冻结研究方案前完成以下检查:[2,3,5]
- 为待研究的机制定义一个每次运行都能观测的代理指标(次数或比率),并在已有记录里找出真实实例;
- 先做预实验,规模要让设定的下限至少对应 5 次预期出现,即下限为每次运行 f 次时至少运行 5/f 次(例如 f = 0.5 时至少 10 次);
- 确认代理指标超过事先声明的下限;如果处理通过某个可观测步骤起作用,还要确认这一步在处理组中确实出现;
- 预实验的运行不得计入验证性样本;
- 任一检查不通过,就在报告标题下直接写明该研究无法检验这一假设,空结果也不算作否证。
输出格式随之增加 Manipulation Check 一行,记录代理指标、下限、预实验结果和处理步骤是否出现;研究方法技能(research-methodology)也写入了“操纵效度”。
-
新增评测用例:
hypothesis-testing/test-manipulation-check让一个记忆功能在全新会话的单步任务上接受测试,这种条件下机制根本没有机会发挥作用,题目也不提示解决办法。广义评测用例因此增至 34 个。[2,3] -
修复:
evals/test-cases/README.md中的评分细则说明改为由用例文件重新生成,并用测试固定,避免与评分程序实际使用的内容不一致。[2] -
测试情况:PR #64 写明 989 项测试通过。[4]
截至 2026 年 10 月 20 日,Releases 页面已有更新的版本:v2.9.0(10 月 17 日)要求每篇被引文献都有引用核查报告;v2.10.0(10 月 19 日)让证据校验能发现否定或方向反转、数字互换、作者-年份引用对应多篇文献、手工填入未经核查的 DOI 四类错误;v2.11.0(10 月 19 日)支持从 Zotero 7 文献集、BibTeX 或 CSL JSON 导出文件、PDF 文件夹导入个人文献库做综述。[6]
Co-Researcher 的特点是把一部分研究方法要求写成 AI 助手必须遵循的步骤,并为文献综述配上不依赖模型的程序化校验。v2.8.2 的操纵检查针对实验设计中一个容易忽视的漏洞:没有观察到效应,可能只是因为实验条件从未让被研究的机制发生。下面依据 README、发布说明和 PR 页面整理它对科研用户的用途和需要注意的边界,并非实测结论。
科研场景中的用途
- 用 AI 设计实验或评测时做前置检查:例如想检验某个 Agent 的长期记忆能否提升表现,如果测试任务都是一次性对话、每次都新开会话,记忆机制就没有机会被调用。按 v2.8.2 的流程,Agent 应先用预实验确认“记忆被实际检索”这类代理指标达到下限,达不到就报告研究无法检验,而不是得出“记忆无效”的结论。[2,3,5]
- 更谨慎地解读空结果:输出中的 Manipulation Check 一行把“假设被否证”和“研究无法检验”区分开,便于在论文的方法与局限部分如实说明。[2,5]
- 可复查的文献综述:综述过程写入当前目录下的工作区,包括检索方案
protocol.md、候选文献与筛选记录corpus.json、每个被引句子对应原文引文的claims.json和核查后的参考文献refs.json,研究者可以逐项复查。[1] - 核查参考文献:
verify_citations.py能标出查不到、信息不匹配或已撤稿的引用。2026 年 10 月 15 日发布的 v2.8.1 修复了中文、日文、韩文和西里尔文标题被误判为不匹配的问题,引用中文文献较多的用户应使用 v2.8.1 及以后的版本。[1,6] - 跨平台使用:同一套技能可在 Claude Code、Gemini CLI、Codex 和 OpenCode 中使用,课题组成员使用不同助手时也能按同一流程工作。[1]
局限与注意事项
- 未经实测:本文为资料核验,未安装实测,功能描述均来自 README、GitHub 发布说明、PR 页面和技能文件。
- 操纵检查依赖 Agent 自觉执行:这一步写在假设检验技能的说明文字里,由 Agent 按说明执行。发布说明没有提到类似
validate_review.py的程序化强制校验,PR #63 也把影响范围标为提示词行为(prompt-behaviour)。实际是否执行到位取决于所用模型,需要人工核对输出中的 Manipulation Check 一行。[3,5] - 校验只管“是否忠于来源”:README 说明,这些检查只能确认综述所说与来源一致,不能确认来源本身正确,也无法判断语义,例如把论文中的“提示”写成“证明”的句子可以通过校验。[1]
- 评测为项目自评:README 中的 34 个广义质量用例和 16 个证据完整性用例由项目自行维护和发布,不是独立评测。[1]
- 许可证要分开看:项目本身采用 MIT 许可证,但可选的运行依赖
pymupdf4llm(及其后端 PyMuPDF)采用 AGPL-3.0,只在read_paper.py提取 PDF 文本时由uv拉取。如果对外提供基于read_paper.py的服务,需要遵守 AGPL 条款。[1] - 全文获取有限:全文只通过合法的开放获取渠道读取,拿不到全文的文献只能依据摘要,README 把这种情况列为警告。[1]
- 版本更新频繁:10 月 13 日至 19 日共发布了 7 个版本。v2.10.0 的发布说明提醒,在 v2.9.0 下通过校验的综述可能在 v2.10.0 下不通过;v2.11.0 的 Zotero 导入尚未在真实的 Zotero 上测试。使用时应记录所用版本。[6]