
Unstructured 是开源的 Python 文档预处理库,采用 Apache-2.0 许可证,可把 PDF、HTML、Word、邮件等文件拆分成带类型和元数据的文档元素,供检索与大模型流程使用。2026 年 10 月 15 日发布的 0.27.27 修复了 HTML 数学公式丢失、JSON 回读改写元素 ID、编码误判不报警等问题。本文为资料核验,未安装实测。
项目定位与安装
项目托管在 GitHub 的 Unstructured-IO/unstructured 仓库(github.com/Unstructured-IO/unstructured),仓库中的 LICENSE.md 为 Apache License 2.0。[1,2]
README 把它定位为面向非结构化数据的开源预处理组件。最常用的入口是 partition():先识别文件类型,再调用对应格式的分区函数,把文档拆成标题、正文段落、列表、表格等文档元素。每个元素带有 ID 和元数据,例如来源文件名、表格的 HTML 形式。拆分结果可以继续分块,再交给向量检索或大模型使用。[1,5]
安装有 PyPI 和 Docker 镜像两种方式。纯文本、HTML、XML、JSON 和邮件只需 pip install unstructured;其他格式要安装对应扩展,例如 unstructured[docx,pptx],或一次装齐的 unstructured[all-docs]。处理 PDF 和图片还需要系统中装有 poppler、tesseract 等软件,Office 文档需要 LibreOffice。[1]
0.27.27 更新内容
0.27.27 于 2026 年 10 月 15 日(UTC)在 GitHub 发布,变更范围是 0.27.25 到 0.27.27。按发布说明和 CHANGELOG,本版以修复为主:[3,5]
- 基础 MathML 支持:HTML 中的
<math>元素会从alttext属性或受支持的 TeX/LaTeX 注释中提取文本表示。行内公式留在所在段落里,display="block"的公式单独成为一个元素;KaTeX 同时输出 MathML 和 HTML 时,同一公式不会被重复提取。 - JSON 回读保留元素身份:
partition_json()读回已序列化的元素时,不再用 JSON 容器的属性替换原有的元素 ID 和已存元数据。 - 编码检测不再静默返回乱码:自动检测旧式编码或无 BOM 的 UTF-16/32 时,会发出
EncodingDetectionWarning,调用方可以用 Python 的警告过滤器把它升级为异常。检测顺序改为先认 BOM、再验证严格 UTF-8、最后做统计判断;没有可用候选时直接报错,不再默认接受第一个能解码的编码。 - 长文档的重叠分类标签:
identify_overlapping_or_nesting_case()从第 100 个元素起会把编号残留混进类别名,现已修正。 - 缺失文本统一为空字符串:
Text及其子类(包括Image)把text=None存为空字符串,避免没有识别出文字的图片元素在转字符串时出错。 - 邮件附件:
partition_email()遇到multipart/*附件(例如 PGP/MIME 签名的转发邮件)不再抛出KeyError,也不会再漏掉这类附件自身的正文。
夹在两次发布之间的 0.27.26 在 CHANGELOG 中还有一条改动:每个进程首次调用公开分区函数时显示一次使用提示,可设置 UNSTRUCTURED_DISABLE_NOTICE=1 关闭。[5]
截至 2026 年 10 月 20 日,Releases 页面已有更新的版本。0.27.28(10 月 16 日)保留了 HTML 表格的标题(caption),解析器不认识的 HTML 元素中的文字也不再丢失;0.27.29 和 0.27.30(均为 10 月 19 日)分别修复了部分旧版 .xls 文件的读取和邮件中非 ASCII 姓名、地址的显示。[4,5]
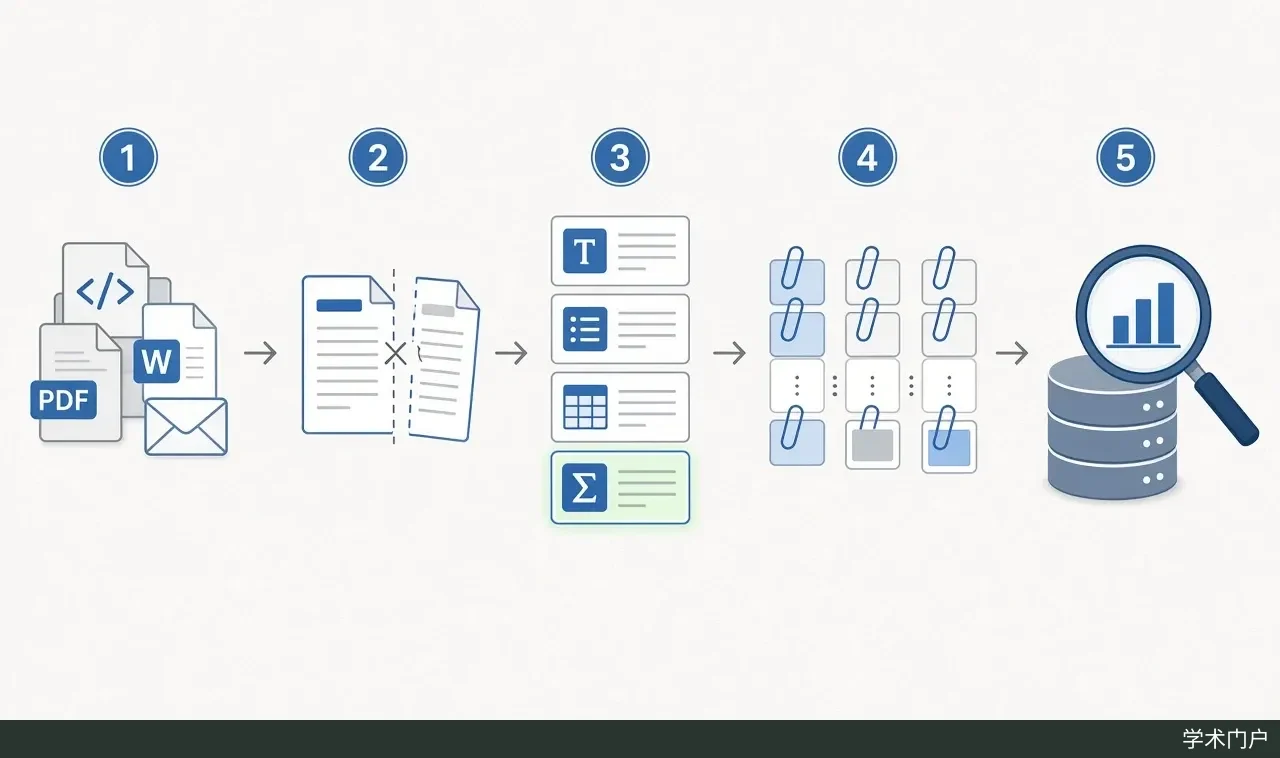
在科研资料的处理链条里,Unstructured 处在最上游:论文 PDF、期刊网页、会议邮件先被拆成结构化元素,后面的分块、检索和问答才有可用的输入。这一层一旦出错,例如公式被丢掉、元素 ID 发生变化、乱码被当成正文,后续环节通常很难察觉。下面依据官方 README、发布说明和 CHANGELOG,整理它对科研用户的用途和需要注意的边界。
科研场景中的用途
以下场景依据官方文档整理,并非实测结论:[1,3,5]
- 搭建个人或课题组文献库:把 PDF、Word、HTML 等资料批量转成统一的元素列表,再接入自己选择的分块和检索工具,不同格式的资料可以按同一套流程处理。
- 处理含公式的网页和讲义:从 0.27.27 起,含 MathML 的 HTML 页面(例如用 KaTeX 渲染的课程讲义、科研博客)中的公式能以 TeX 或替代文本的形式保留,行间公式单独成段,检索时有机会命中公式内容。
- 保持标注和引用的定位:如果把解析结果存成 JSON,之后再读回来做标注、摘录或建立引用关系,从 0.27.27 起元素 ID 和元数据会保持原样,基于 ID 的关联不会因为回读而断开。
- 批量处理来源杂乱的文本:旧系统导出的文本、多语种资料常有编码问题。新版对不确定的编码判断发出警告,可以在批处理脚本里把警告转成异常,把可疑文件挑出来人工检查,避免乱码静默进入索引。
- 整理学术邮件:会议通知、审稿往来等邮件可以用
partition_email()处理,本版修复了一类转发的签名邮件导致整封处理失败的问题。
局限与注意事项
- 未经实测:本文为资料核验,未安装实测,功能描述均来自 README、GitHub 发布说明和 CHANGELOG。
- 公式支持是基础级的:MathML 的文本提取依赖
alttext或受支持的 TeX/LaTeX 注释,这次修复针对 HTML 分区。CHANGELOG 没有说明 PDF 中公式的处理有变化,PDF 论文里的公式仍需单独检查。[5] - 编码检测仍是启发式的:CHANGELOG 明确写道,这次改动不保证在编码未知时还原原文。已知编码时应直接指定。[5]
- 升级可能改变内容哈希:原本
text为空值的元素现在序列化为空字符串,重新计算的内容哈希会随之变化。用元素 ID 或哈希做去重、增量更新的资料库,升级后应抽查一遍。[5] - 复杂版面需要人工核对:README 引用的厂商自测基准中,开源库的表格单元格内容得分为 0.426,文本准确度为 0.715。这是厂商数据,不是独立评测,但说明复杂表格和版面的解析结果需要人工核对。[1]
- 默认发送匿名统计:README 说明,库在导入时和每次调用公开分区函数时,默认向官方地址发送轻量统计,不含文档内容、文件名和路径。不希望发送时,在导入前设置
DO_NOT_TRACK或SCARF_NO_ANALYTICS环境变量即可关闭。[1] - 依赖较多:处理 PDF、图片和 Office 文档需要额外的 Python 扩展和系统软件,在权限受限的服务器或个人电脑上安装前,应先确认这些依赖能否装上。[1]
- 注意版本更新:0.27.27 之后已发布 0.27.28 至 0.27.30,新部署可以先查看最新版本的发布说明再选择版本。[4]