
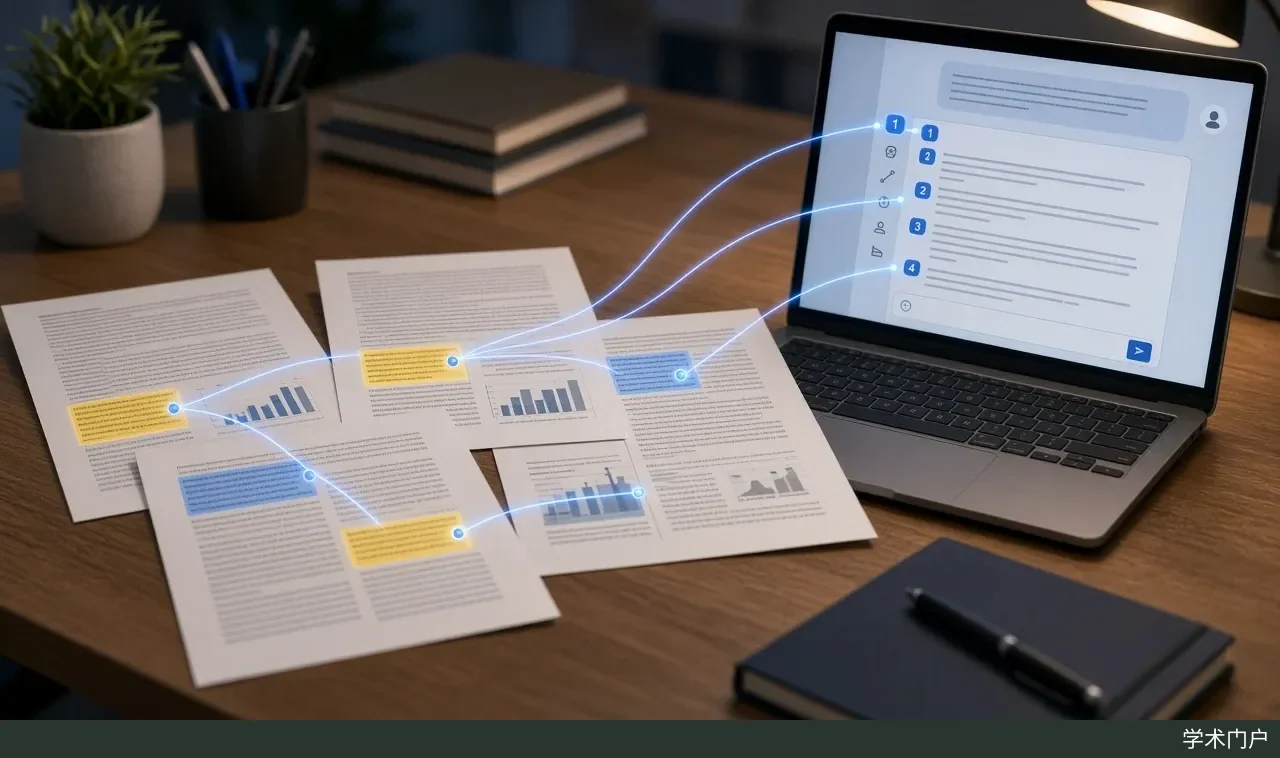
RAGFlow 是开源的检索增强生成(RAG)引擎,可把论文、报告等文档解析入库,结合大模型做带出处的问答与 Agent 工作流。2026 年 10 月 16 日发布的 v1.0.0-rc2 是 1.0 正式版的第二个候选版本,新增 Agentic 对话模式。本文为资料核验,未安装实测。
项目定位与工作方式
RAGFlow 托管在 GitHub 的 infiniflow/ragflow 仓库(github.com/infiniflow/ragflow),官方网站与文档位于 ragflow.io。仓库 LICENSE 为 Apache License 2.0。[1,2]
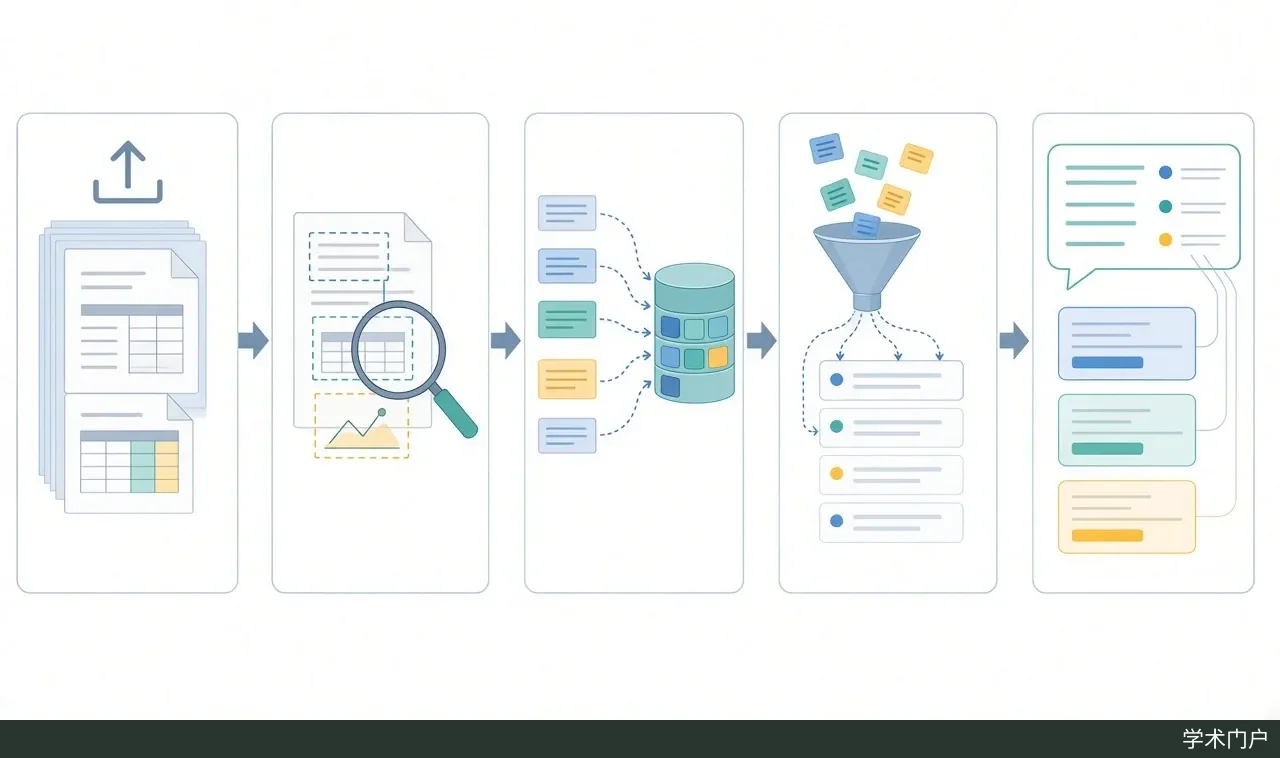
按 README 的介绍,它的基本流程是:先对 Word、PPT、Excel、TXT、PDF、扫描件、图片、网页等资料做深度文档理解(其中 DeepDoc 模块负责版面分析、OCR 和表格识别),再按模板把内容切成文本块并建立索引;提问时多路召回、融合重排序,回答附带可追溯的引用。切块结果可以可视化查看,并允许人工干预。[1]
在问答之外,README 还介绍了两项较新的能力:[1]
- 知识编译(Knowledge Compilation):在文档或数据集层面生成 Wiki、图谱、树、PageIndex、思维导图、时间线等结构化产物,可查看、更新和重新生成。
- Agentic 检索:面对复杂问题,由模型分析并在需要时拆解问题,多轮检索、核对证据后再作答。
部署支持 Docker 和源码启动两种方式。从 v1.0.0-rc1(2026 年 9 月 29 日)起,RAGFlow 改用 Go 语言全面重写,发布说明称这显著降低了系统资源占用,消息队列也从 Redis 换成了 NATS。[1,4]
v1.0.0-rc2 的主要变化
v1.0.0-rc2 于 2026 年 10 月 16 日(UTC)发布在 GitHub Releases,是 v1.0.0 的第二个候选版本,上一个候选版 v1.0.0-rc1 发布于 9 月 29 日。截至 2026 年 10 月 20 日核对,它是 Releases 页面标为最新(Latest)的版本,比它新的只有滚动更新的 nightly 构建。[3,4] 发布说明列出的要点如下:[3]
- Agentic 对话模式:对话新增 Agentic 模式,取代原来的 Low、Medium、High、Ultra 四档思考等级。合并记录显示,对话页面现在只保留 Naive(普通)和 Agentic 两种模式。
- 解析器统一:12 种内置文档解析器与 Pipeline 解析器合并,在同一个下拉菜单中选择。
- 模型与工具:新增 DemonRoute、Opper 两家模型服务商,Firecrawl、Search1API 两种联网搜索工具,以及对 MinerU 4 模型的支持。
- 图片处理:解析图片时可选启用视觉语言模型(VLM)增强,图片 OCR 改为独立开关。
- 协作与部署:支持 Team/Me 共享(rc1 发布说明曾将其列为尚未支持的功能),新增 arm64 架构的 Docker 镜像,检索新增捷克语和斯洛伐克语支持。
- 升级路径:保留对 rc1 数据的兼容,可从 rc1 直接升级。
合并记录中还有较多文档解析方面的修复,例如 PDF 图注合并时丢失文字和图片、页眉页脚与目录的误删判断,以及表格合并单元格的处理。[3]
做文献综述或课题调研时,难点往往不是找不到资料,而是要在几十上百份 PDF 中确认某个方法、数据或结论出自哪份文献的哪一段。RAGFlow 这类 RAG 引擎的做法是先把文档解析、切块、建索引,再让大模型依据检索到的原文片段作答并标注出处。下面依据官方 README 和发布说明,整理它对科研用户可能的用途和需要注意的边界。
科研场景中的用途
以下场景依据官方文档整理,并非实测结论:[1,3]
- 课题组文献库问答:把一个方向的论文、综述和技术报告建成数据集,提问时回答附带引用,可以回到原文片段核对。rc2 把引用定位扩展到所有可预览的文件类型,并支持从引用中的图片预览原文档。
- 版式复杂的论文:PDF 除内置的 DeepDoc 外,还可以接入 MinerU、Docling 等外部解析服务,本版新增对 MinerU 4 的支持和图片的 VLM 增强。公式、表格、图片较多的论文,可以分别试用不同解析器,对比切块结果后再选定。
- 跨文档的综合问题:例如“这几篇论文分别用了什么数据集、结论有何差异”,Agentic 模式会拆解问题、多轮检索后作答,比单次检索更适合这类比较。
- 整理领域脉络:知识编译可以按文档或数据集生成 Wiki、时间线、思维导图等,适合梳理一个方向的发展线索,但生成内容仍需人工核对。
- 研究 RAG 系统本身:代码以 Apache-2.0 许可证开源,解析、切块、检索、Agent 编排各环节可以分别替换和比较,适合作为对照实现阅读。
局限与注意事项
- 未经实测:本文为资料核验,未安装实测,功能描述均来自 README 和 GitHub 发布说明。
- 仍是候选版本:GitHub 虽把 v1.0.0-rc2 标为最新版本,未勾选“预发布”,但它仍是 1.0 正式版之前的候选版本,rc2 本身也移除了部分旧的对话会话兼容接口。已有部署升级前应备份数据,先在测试环境验证。[3]
- 从 0.x 升级不可回滚:rc1 发布说明写明,从 v0.27.2 升级到 1.0 时会自动迁移数据,迁移后无法回滚到 v0.27.2;升级前须先处于 v0.27.2 并备份全部数据。Go 实现不再支持已弃用的 API,Python SDK 不受影响。[4]
- 硬件与平台:README 建议的 Docker 起步配置为 4 核 CPU、16 GB 内存、50 GB 可用磁盘,并要求 Docker ≥ 24.0.0、Docker Compose ≥ v2.26.1;实际需求随数据量、解析任务和并发增加,本地模型另需资源。macOS 目前不受支持;开源 1.0 版本中 DeepDoc 的版面分析、OCR 和表格识别使用 CPU 推理。[1]
- 模型需自行配置:启动后要在模型服务页面添加大模型、向量模型和重排序模型,填写服务地址和 API 密钥。使用云端模型服务时,问题和检索到的文档片段会发送给服务商;涉及未发表数据或敏感材料时,应先确认数据去向,或改用本地部署的模型。[1]
- 回答质量取决于解析:README 用“Quality in, quality out”概括这一点。双栏排版、公式和扫描件的解析效果因文档而异;回答带有引用也不等于结论正确,关键内容仍应回到原文核对。[1]
- 开源范围:Apache-2.0 覆盖的是仓库代码;官方另有云服务 cloud.ragflow.io,两者需要区分。[1,2]
参考文献
[1] infiniflow/ragflow GitHub 仓库与 README [2] 仓库 LICENSE(Apache License 2.0) [3] RAGFlow v1.0.0-rc2 发布说明,2026-10-16 [4] RAGFlow v1.0.0-rc1 发布说明,2026-09-29
仓库与 README 为滚动更新内容,按 2026 年 10 月 20 日核对时的内容(v1.0.0-rc2 标签)引用。