
科研 Agent 按验收标准自查的示意:笔记本电脑终端窗口旁是一张检查清单,已通过的条目打绿勾,待修改的条目以琥珀色循环箭头标出。此图不是 EvoScientist 的真实界面截图。AI 生成示意图。
EvoScientist 是面向科研任务的开源 AI Agent 项目,由多个子智能体分工完成调研、编程、分析和写作。2026 年 10 月 17 日发布的 0.3.7 版加入了验收标准机制:用户给出检查清单或研究目标,独立的评审步骤在 Agent 停下时逐条核对,未达标就退回继续修改。本文为资料核验,未安装实测。
项目托管在 GitHub 的 EvoScientist/EvoScientist 仓库(github.com/EvoScientist/EvoScientist),采用 Apache License 2.0。据 README,它由计划、调研、编程、调试、分析、写作 6 个子智能体协作,按“接收任务、计划、执行、评估、写作、核验”的流程推进研究任务;每轮对话的要点会沉淀为跨会话的记忆,反复出现的做法可整理成技能,经用户审核后复用。项目建立在 LangChain 与 DeepAgents 之上,可通过 MCP 接入外部工具,也支持按 cron 表达式运行定时任务。使用入口包括终端里的 TUI 与经典命令行、浏览器中的 WebUI,以及 Telegram、Slack、飞书、微信等聊天渠道。模型由用户自行配置,可填入 Anthropic、OpenAI、Google、MiniMax、NVIDIA 等服务商的 API 密钥,也可用已有的订阅账号登录。项目于 2026 年 3 月 13 日首次公开发布,两天前团队在 arXiv 发布了技术报告(arXiv:2603.08127),描述了借助持久记忆不断调整研究策略的多智能体框架。
让 AI Agent 处理文献调研、实验复现或数据分析时,任务“跑完了”不等于交付物合格:综述可能漏掉关键文献,分析脚本可能没有输出可复现的结果。0.3.7 版的主要改动正针对这一点,让用户事先写明什么算完成,再由独立的评审步骤据此检查。下面依据官方发布说明、README 和使用指南,介绍这一版的改动、在科研工作中的用法,以及需要注意的边界。
0.3.7 版的主要改动
0.3.7 版于 2026 年 10 月 17 日(UTC)发布在 GitHub Releases,上一版 0.3.6 发布于 10 月 9 日。最主要的变化是验收标准。单次运行时,可以用 --rubric 附上一份检查清单,直接写在命令里或用 @文件名 读取;Agent 每次停下,独立的评审步骤会对照清单检查工作,未满足的条目退回给 Agent 继续做,直到全部通过或达到轮数上限。在交互式终端会话中,/rubric set 让同一对话的每一轮都接受检查,/rubric next 只检查下一项任务。/goal 面向只有目标、还没写好清单的情况:用户描述研究目标,系统先起草验收标准交给用户审核,可以接受、提出修改或取消;接受后每一轮都对照这些标准评分,直至达成。目标之后还可以修改、暂停、恢复或清除。
其他改动包括:macOS、Linux 和 Windows 都可以用一行命令安装,脚本会获取经过校验的 uv,并按该版本测试过的依赖版本安装;新增 EvoSci update 命令,可在版本之间升级或回退,回退前会备份配置文件。模型请求遇到服务器错误、限流或连接中断时,会在设定的等待时间内自动重试,并可沿备用模型链切换。以服务模式运行时,在聊天渠道中开启 /proactive 后,若对话沉寂一段时间(默认 120 分钟,夜间免打扰时段除外)且有新情况,系统会判断是否主动发送一条跟进消息,每个沉寂期最多一条。此外,ChatGPT Plus/Pro 用户可以直接登录;后端只响应来自本机等受信页面的浏览器请求;模型列表有增有减,新配置默认使用 Claude Sonnet 5.5。
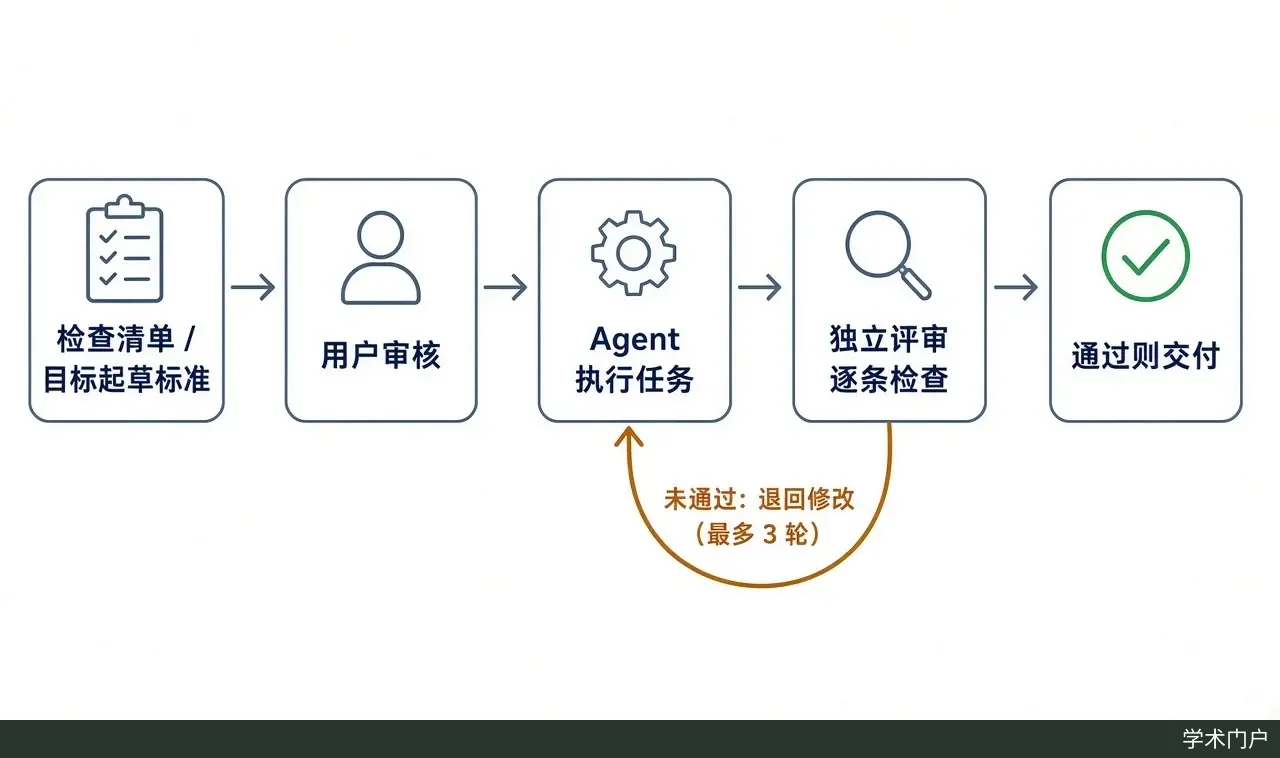
验收标准工作流程示意:用户提供检查清单,或由 /goal 起草标准并经用户审核;Agent 执行任务后由独立评审逐条检查,未通过的条目退回修改,每项任务最多 3 轮。流程依据 EvoScientist 0.3.7 发布说明与官方使用指南整理,不是软件界面截图。AI 生成示意图。
科研工作中的用法
官方指南给出的示例是“复现论文中的表 2 并绘制消融实验图”,配套清单要求 results/table2.csv 中每个基线占一行、figures/ablation.png 必须存在。可以看出,验收标准最适合写成可以核对的交付物:哪些文件必须存在、应包含哪些部分、最少有多少条。照这个思路,文献调研可以要求列出所用数据库和检索式、每条文献附 DOI 或链接;数据分析可以要求保存脚本、结果表和随机种子。README 中的定时任务也能附检查清单,例如每天汇总前一天的 arXiv 论文时,要求每条都有标题、链接和一句话摘要,某条要求未满足时会带着评审意见重跑一次。需要无人值守批量运行时,单次运行的退出码可以说明结果:0 表示最后一轮检查通过,3 表示没有得到通过判定,1 表示运行本身失败。
局限与注意事项
验收通过不等于科学上正确。按官方指南,评审步骤只能查看本轮对话、列出和读取工作区文件,不能运行命令,因此“测试通过”这类条目只能依据对话中的记录判断。评审默认使用辅助模型,未配置时用主模型;发布说明提到个别模型无法给出判定,需要另指定辅助模型。每项任务最多检查 3 轮,3 轮仍未通过时,单次运行以未通过结束,目标模式则停下等待用户继续、修改或清除。/goal 的标准由主模型起草,在自动模式下会不经审核直接采用。清单是否合理、评审模型能否发现错误,最终仍要研究者把关:文献是否遗漏、统计方法是否恰当,很难只靠检查文件来判断。
适用范围也有限制:/rubric 和 /goal 只在 TUI 与交互式命令行中生效,WebUI 和 EvoSci serve 不做评分,聊天渠道会话中会直接拒绝;主动跟进只在服务模式且后端设为 langgraph_server 时可用。安全方面,Agent 能执行 shell 命令,默认每次需要人工批准;README 提醒后端是不需认证的接口,若开放到局域网,能访问端口的人就能控制它。升级方面,Windows 上用 uv pip install 装入的 MCP 与聊天渠道依赖会在下次更新时被移除,需要重新安装;配置里如果写了已移除的模型简称,升级后会报错,WebUI 与 deploy 后端无法启动,需改用新的模型名。另外,每次运行和每轮评审都会消耗模型调用额度;使用云端模型时,任务内容会发送给所选服务商,处理未发表数据前应先评估。