
伯明翰图书馆二层“知识楼层”,读者在窗边长桌前阅读或使用笔记本电脑。此图仅表现文献查阅场景,不是 Feynman 的界面截图。图:Elliott Brown,来源 Wikimedia Commons,CC BY-SA 2.0。

Feynman 是 Companion, Inc. 开发的开源科研 AI 智能体,主要在终端中运行,可以检索 OpenAlex、arXiv、PubMed 等学术来源,完成文献综述、深度调研和论文评审等任务。2026 年 10 月 18 日发布的 v0.5.50 改进了多智能体研究流程:主进程意外终止时,已完成的研究子任务会保留结果。本文为资料核验,未安装实测。
项目源代码托管在 GitHub 的 Companion-Inc/feynman 仓库(github.com/Companion-Inc/feynman),官方网站与文档位于 feynman.is。仓库中的 LICENSE 文件为 MIT 许可证,版权方为 Companion, Inc.。macOS 和 Linux 可用官方一行安装脚本安装,Windows 用 PowerShell 脚本安装,也可以在 Node.js 22.22 及以上版本中执行 npm install -g @companion-ai/feynman;官方文档说明它通过 Bash 执行命令,Windows 用户还需安装 Git for Windows。Feynman 构建在开源智能体运行环境 Pi 之上,内置 researcher(调研)、verifier(核查)、reviewer(评审)、writer(写作)四个研究角色。它不自带模型,首次使用需运行 feynman setup,通过账号登录或 API 密钥连接模型服务,也可以接入 LM Studio、Ollama 等本地模型。截至本文核验(2026 年 10 月 20 日),GitHub Releases 上的最新版是 10 月 19 日发布的 v0.5.51,它只改进了登录凭据文件损坏时的报错提示,并为两条旧命令补充了新命令的指引。
做一次文献调研,通常要在多个数据库之间检索、比对证据、整理分歧,再写成综述或评审意见。Feynman 把这些步骤做成可以直接调用的命令行工作流,由多个分工不同的智能体并行完成,并把用过的来源写进记录文件,方便事后逐条核对。下面依据官方 README、文档和发布说明,介绍它的工作流、近期版本变化和使用边界。
研究工作流与学术来源
README 列出了十个工作流命令。与文献工作关系最密切的有:/lit 做文献综述,归纳共识、分歧和尚未解决的问题;/deepresearch 先制定调研计划,再由多个研究智能体并行调研并核查引文;/review 给出按严重程度分级的评审意见和修改计划;/audit 把论文中的主张与其公开代码对照;/compare 生成多个来源的对比矩阵;/summarize 总结一篇论文、一个代码仓库或一份 PDF;/draft 依据调研结果写出论文体草稿。/replicate 生成复现计划,用户选定运行环境后才会执行;面向机器学习的 /recipe 和 /autoresearch 分别用于整理训练方案和针对基准测试做有限轮次的实验循环。结果保存在 outputs/ 目录,草稿保存在 papers/ 目录;/lit、/deepresearch 和 /recipe 还会写出一份来源记录文件,列出用到的来源以及核实了哪些内容。
检索范围包括 alphaXiv、Semantic Scholar、OpenAlex、arXiv、PubMed、Europe PMC、bioRxiv、medRxiv、Crossref、Hugging Face 和普通网页,也能读取本地 PDF 和文档。README 建议免费申请 OPENALEX_API_KEY 和 SEMANTIC_SCHOLAR_API_KEY,以避开共享的访问频率限制。近一周的几个版本也在修补论文查找:v0.5.45(10 月 13 日)在 arXiv 超时或过载时改由 Semantic Scholar 按 arXiv 编号查找,并附说明;v0.5.46(同日)让 OpenAlex 尚未收录的新 arXiv 预印本可以按 DOI 直接在 arXiv 上查到;v0.5.48(10 月 16 日)修复了参数中含有 \usepackage 这类反斜杠序列时字段丢失的问题,这会影响草稿和论文中的 LaTeX 内容。
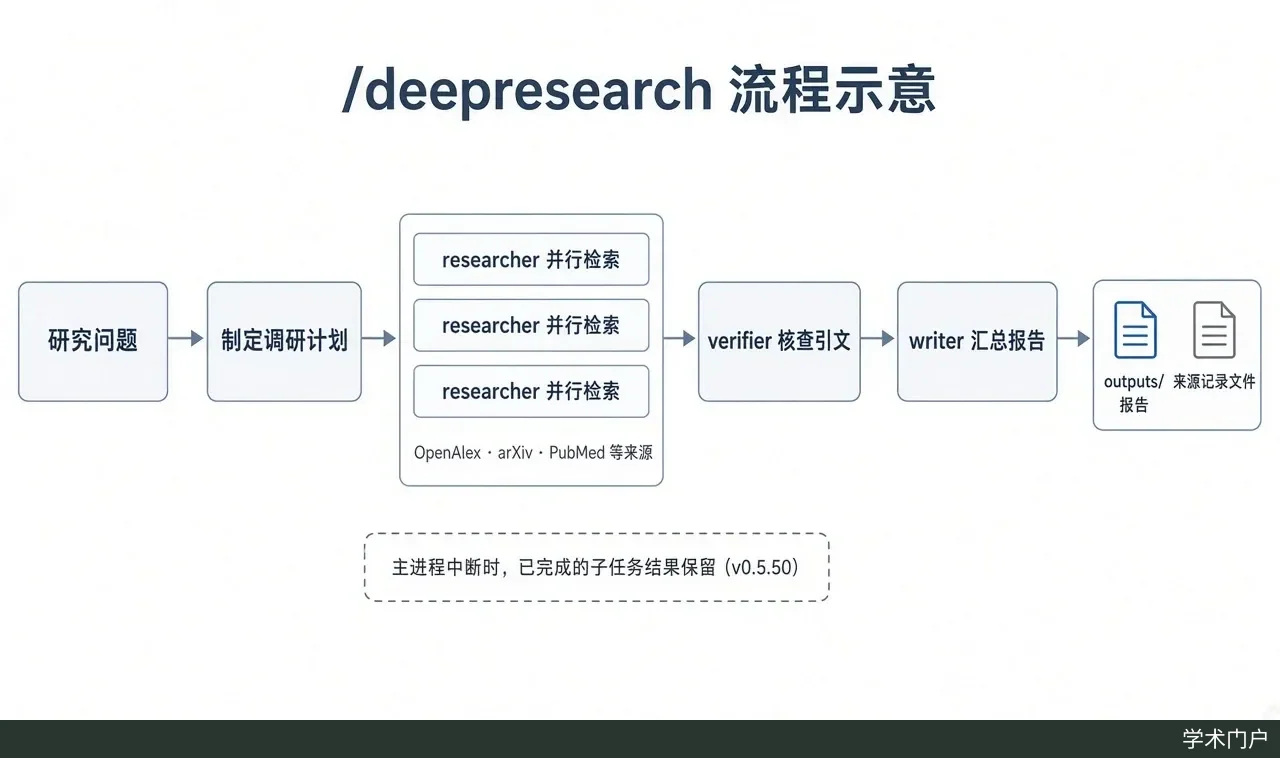
Feynman /deepresearch 流程示意:制定调研计划后,多个 researcher 并行检索,再由 verifier 核查引文、writer 汇总报告,结果与来源记录文件写入 outputs/。流程依据项目 README 与 v0.5.50 发布说明 整理,不是官方架构图。AI 生成示意图。
v0.5.50 的改动与前后版本
v0.5.50 于 2026 年 10 月 18 日发布(GitHub 记录的发布时间为 UTC 13:56),随附的子智能体组件 pi-subagents 升级到 0.79.1。发布说明列出四项改动:还没有委派子任务的会话,不再在每次请求中附带 bg_wait 和 subagent_supervisor 两个工具定义,每次请求约少发送 1,500 个字符;工作流主进程意外终止时,已经完成的研究子智能体会保留结果,不再被标记为失败;界面中的工作流面板和 status 输出会显示每个子智能体所用的模型;以只读方式安装时,每次启动不再因升级提示记录“permission denied”错误。对一次要并行运行多个子任务的深度调研来说,第二项改动意味着中途出错时,已完成的部分不必全部重跑。该版本在 Releases 页提供 macOS、Linux(x64 与 arm64)和 Windows x64 的预编译包,以及 SHA256SUMS 校验文件。
前一版 v0.5.49(10 月 17 日)让并行分出的研究子智能体复用父任务的提示缓存,/subagent-cost 报告也不再附在之后的每次请求里,发布说明称并行运行因此消耗更少的 token,但没有给出具体幅度。同一版本中,模型服务商因内容过滤等原因中止子智能体时,错误信息会附上服务商的回复,用户可以分辨是被拒绝执行还是服务故障;.env.example 加入了 OPENALEX_API_KEY,用于在长时间文献检索中提高 OpenAlex 的访问频率上限。后一版 v0.5.51(10 月 19 日)没有功能变化,只在 ~/.feynman/agent/auth.json 不是有效 JSON 时指明出错的文件和处理办法。
局限与注意事项
Feynman 本身不提供模型,调研的质量、速度和费用取决于所连接的模型服务。官方文档提醒,小型本地模型经常跳过多步骤研究工作流,只在对话中作答而不向 outputs/ 写入文件;上下文窗口过小也会出现同样情况,例如 Ollama 默认的上下文只有几千个 token,需要手动调大。部分搜索服务按次计费,如 v0.5.49 新增的 DeepSeek 搜索,自动模式不会选用它。
来源记录文件能说明用了哪些来源、核实了什么,但综述、评审意见和草稿仍是模型生成的内容,可能遗漏文献或误读结论,引用、数字和关键判断需要对照原文核对。Feynman 会通过 Bash 执行命令,/replicate 虽然要等用户选定环境后才运行,处理敏感数据或在共享服务器上使用前,仍宜先确认它将执行的操作。登录凭据默认保存在 ~/.feynman/agent/auth.json,文件权限仅限当前用户;也可以只在终端环境变量或 .env 文件中设置密钥,不写入该文件。
README 说明,Feynman 默认向 PostHog 发送匿名使用数据,包括命令、工作流、工具、模型、token 数量以及错误信息和堆栈,不发送提示词、模型输出、论文内容或工具参数;设置 FEYNMAN_TELEMETRY=off 可以关闭。项目更新很快:10 月 13 日至 19 日共发布了 v0.5.42 到 v0.5.51 十个版本,版本号仍处于 0.x 阶段。课题组共享调研流程时,宜记录所用的 Feynman 版本和模型;官方安装脚本支持安装指定版本。