
位于英国欣克斯顿的欧洲生物信息研究所(EMBL-EBI),Europe PMC 由该机构维护。摄影:Magnus Manske,来源:Wikimedia Commons,许可:CC BY-SA 3.0。
Europe PMC(europepmc.org)是由 EMBL-EBI 维护的免费生物医学文献库:收录全部 PubMed 摘要,与美国 PMC 共享全文,另外整合了预印本、专利、临床指南和资助信息。本文依据官方手册和 API 文档,讲清它与 PubMed 的关系、字段检索语法、章节级全文检索与文本挖掘注释,给出 4 个经实际调用的检索式和 API 请求,并说明结果判读要点与局限。
与 PubMed 的关系和收录范围
Europe PMC 与 PubMed 是互补关系,而不是两套互不相干的数据。按 Europe PMC 团队在《Nucleic Acids Research》发表的年度报告,它是 PMC International 的成员,与美国 PMC、PMC Canada 共享全文,并提供全部 PubMed 摘要;2020 年的报告进一步说明,两站新收到的全文每日交换,网站把 PubMed 摘要和对应的 PMC 全文合并在同一个文章页。所以在 PubMed 能查到的记录,在 Europe PMC 里一般以 MED 来源出现。
熟悉本站介绍过的 PubMed MeSH 检索的读者,要注意两点差异。第一,官方字段列表里没有与 PubMed [mh] 对应的独立 MeSH 字段:KW: 同时检索 MeSH 和出版商提供的关键词,CHEM: 检索 MeSH 物质词,结果会比纯主题词检索更宽。第二,API 的 synonym 参数默认关闭,设为 true 时才用 MeSH 术语和 UniProt 同义词扩展检索词,例如把 aspirin 扩展到 acetylsalicylic acid。手册没有说它等同于 PubMed 的自动词语匹配或下位词扩展,做系统检索时不要拿它替代 MeSH 检索式。
官方 Web Service 参考手册(6.9.0 版,2023 年 8 月 31 日)用 SRC: 来源代码区分各类记录,常用的有:
MED:PubMed/MEDLINE 记录。PMC:PubMed Central 全文中没有 PubMed 记录的部分(据 Annotations API 文档的来源说明)。PPR:预印本。2020 年报告称 Europe PMC 自 2018 年起收录预印本摘要,当时来自 15 个生命科学预印本服务器,包括 bioRxiv、medRxiv、Research Square 和 F1000Research 等,同年开始收录 COVID-19 相关预印本的全文。PAT:生物学相关专利,来自欧洲专利局(EPO)。HIR:NHS Evidence 提供的英国临床指南。AGR、CBA、ETH、NBK:分别是 Agricola 农业文献、中国生物学文摘、英国国家图书馆 EThOS 博士论文和 Europe PMC 书架图书。
资助信息不是一个来源代码,而是附在文献记录上的字段。2020 年报告介绍了 Grant Finder 资助数据库(当时覆盖 31 个欧洲资助方),资助与论文的对应关系由资助方、Researchfish 或作者投稿时提供,Europe PMC 还会从文章的致谢与资助部分文本挖掘资助号。检索时用 GRANT_AGENCY:(资助机构)和 GRANT_ID:(资助编号)字段。需要提醒的是,手册的来源表成文于 2023 年,个别来源是否仍在持续更新,使用前可先用 SRC: 单独检索,看最新记录的收录日期。
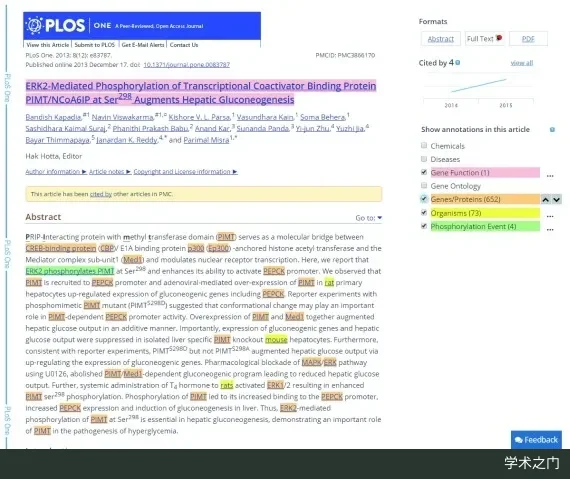
SciLite 在 Europe PMC 文章中显示文本挖掘注释的界面,对应下文“REST API 与文本挖掘注释”一节。图出自 SciLite 论文(Wellcome Open Research 1:25),作者:Aravind Venkatesan 等,来源:Wikimedia Commons,许可:CC BY 4.0。

字段检索语法和检索式
Europe PMC 的检索式写法是“字段名:检索词”,短语加英文双引号,用 AND、OR、NOT 和括号组合,范围用方括号,如 PUB_YEAR:[2020 TO 2024]。下表字段的定义出自官方参考手册附录;完整的可检索字段可以直接请求 API 的 fields 模块获得,它反映的是当前索引,比手册更新。
| 字段 | 用途 | 手册示例 |
|---|---|---|
AUTH: |
作者姓,可加首字母 | AUTH:"einstein G" |
TITLE: / ABSTRACT: / TITLE_ABS: |
标题、摘要、标题加摘要 | TITLE_ABS:"african swine fever" |
AFF: |
作者机构 | AFF:"university of cambridge" |
PUB_YEAR: / FIRST_PDATE: |
出版年、首次出版日期 | PUB_YEAR:[2000 TO 2001] |
SRC: |
来源代码 | SRC:PPR |
OPEN_ACCESS: |
限定开放获取 | OPEN_ACCESS:y |
IN_EPMC: |
Europe PMC 是否持有全文 | IN_EPMC:y |
PUB_TYPE: |
文献类型 | PUB_TYPE:review |
LICENSE: |
知识共享许可 | LICENSE:"cc by" |
GRANT_AGENCY: / GRANT_ID: |
资助机构、资助编号 | GRANT_ID:100229 |
METHODS: / ACK_FUND: / BODY: |
全文的方法部分、致谢与资助部分、正文 | METHODS:"yeast two-hybrid" |
DISEASE: / GENE_PROTEIN: / ORGANISM: |
文本挖掘出的疾病、基因/蛋白、生物体 | GENE_PROTEIN:gng11 |
可检索字段的完整列表:fields 模块
以下检索式都在 2026 年 10 月 22 日通过 REST API 实际调用,命中数只代表当天结果;网页检索框里可直接粘贴同样的检索式。
示例 1:找某个主题的预印本
SRC:PPR AND TITLE:"long covid"
返回 973 条。前两条分别来自 Research Square 和 Qeios,pubType 为 preprint,isOpenAccess 和 inEPMC 均为 N,意思是 Europe PMC 只有这两条的元数据,没有全文。
示例 2:只在方法部分检索
METHODS:"propensity score" AND OPEN_ACCESS:y AND PUB_YEAR:[2024 TO 2025]
返回 14,637 条。METHODS: 只检索全文中的“材料与方法”部分,找的是“实际用了倾向评分”的文章,而不是“标题里提到倾向评分”的文章。
示例 3:按资助机构筛选
GRANT_AGENCY:"Wellcome Trust" AND TITLE_ABS:malaria AND OPEN_ACCESS:y
返回 4,467 条。注意:手册示例写法 GRANT_AGENCY:wellcome 当天实测返回 0 条(加不加引号都一样),而 GRANT_AGENCY:"Wellcome Trust" 单独检索返回 219,262 条。稳妥的做法是先用 resultType=core 取一条记录,看 grantsList 里 agency 的实际写法,再照抄进检索式。
REST API 与文本挖掘注释
REST 检索接口是 https://www.ebi.ac.uk/europepmc/webservices/rest/search,用浏览器或任何 HTTP 工具发 GET 请求即可,本文的所有请求都没有注册或使用 API key。参数含义与官方手册一致,REST 返回的 request 字段也会回显这些参数:query 放检索式;format 选 json 或 xml;resultType 可选 idlist(只返回 ID)、lite(基本元数据,默认值)或 core(全部元数据,含摘要、资助和全文链接);pageSize 默认 25,最大 1000;翻页用 cursorMark,第一页传 *,之后传上一页返回的 nextCursorMark;synonym 默认 false。
示例 4:用 API 批量取回结果
curl "https://www.ebi.ac.uk/europepmc/webservices/rest/search?query=SRC:PPR%20AND%20TITLE:%22long%20covid%22&format=json&resultType=lite&pageSize=100&cursorMark=*"
需要取回全部结果时,按 nextCursorMark 循环翻页。下面是按手册翻页规则写的示意代码,本文没有用它跑完整结果集:
import requests

BASE = "https://www.ebi.ac.uk/europepmc/webservices/rest/search"

def fetch_all(query, page_size=1000, result_type="lite"):
    cursor = "*"
    while True:
        params = {"query": query, "format": "json", "resultType": result_type,
                  "pageSize": page_size, "cursorMark": cursor}
        data = requests.get(BASE, params=params, timeout=60).json()
        results = data["resultList"]["result"]
        yield from results
        next_cursor = data.get("nextCursorMark")
        if not results or not next_cursor or next_cursor == cursor:
            break
        cursor = next_cursor
全文检索有明确边界。手册说明,Europe PMC 的全部内容都能被检索,但大部分全文受版权和许可限制,API 对这类文章只返回元数据和摘要;只有开放获取子集可以取回全文 XML 以及图表、补充材料。METHODS:、ACK_FUND:、BODY: 这类章节字段也只对 Europe PMC 持有全文的文章起作用,只有摘要的记录不会被命中。
文本挖掘注释是 Europe PMC 相对 PubMed 的特色。2020 年报告称注释平台约有 13 亿条注释,来自 10 个提供方,类型包括基因/蛋白、疾病、生物体、GO 术语、化学物质和数据库登录号等,网页端由 SciLite 在文章里高亮这些词。检索时有两种用法:在检索式里加 HAS_TM:y,限定为有文本挖掘结果的全文文章;或用 DISEASE:、GENE_PROTEIN:、ORGANISM:、GOTERM: 直接检索被挖掘出的术语。需要逐条取回注释时,用 Annotations API。
Annotations API 的 annotationsByArticleIds 一次接受 1–8 个文章 ID,格式为“来源:编号”,如 MED:14670548 或 PMC:4771370,可用 type(注释类型)、section(文章章节)、provider(提供方)过滤;annotationsByEntity 按实体名找文章,每页 1–8 篇,filter=1 时只返回命中该实体的注释。
https://www.ebi.ac.uk/europepmc/annotations_api/annotationsByArticleIds?articleIds=PMC:4771370&type=Diseases&format=JSON
2026 年 10 月 22 日调用时,接口返回了这篇文章(PMID 26864432)的记录,但 annotations 是空数组。这只说明注释库里没有它的疾病类注释,不能推出文章没有讨论疾病;去掉 type 参数可以查看它有哪些类型的注释。
结果判读与局限
- 命中数是当天的实时数字。 Europe PMC 每日更新,报告检索结果时要写明检索日期和完整检索式。本文的数字都是 2026 年 10 月 22 日的结果。
- 同一项研究可能有多条记录。 预印本(
PPR)和期刊版(MED)各成一条,2020 年报告称两者会互相链接。合并结果时按 DOI、PMID 去重,并事先决定是否保留预印本。 - 日期字段含义不同。
firstIndexDate是收录进 Europe PMC 的日期,不是发表日期。示例 3 中单独检索GRANT_AGENCY:"Wellcome Trust"返回的首条记录,firstIndexDate为 2026-09-03,pubYear却是 2027(印刷期号日期在后)。按时间筛选时,要想清楚用PUB_YEAR:、FIRST_PDATE:还是FIRST_IDATE:。 - 许可标记不等于能读全文。 上面那条记录的
license显示 cc by,但isOpenAccess和inEPMC都是 N,全文链接标注 Subscription required。判断能否阅读,优先看fullTextUrlList里各链接的可获取性说明,再用 Unpaywall 等工具核查。 - 章节检索会漏掉只有摘要的文章。 统计“某方法的使用比例”时,分子分母要用同样的全文范围(例如都加
IN_EPMC:y),否则比例会被低估。 - 字段取值依赖数据录入。 资助机构名、许可写法各不相同,手册示例也可能与现行索引不符(如上文的
GRANT_AGENCY:wellcome)。正式检索前,先取几条记录核对实际取值。 - 文本挖掘是自动标注。 可能漏标或错标,适合发现线索,不宜直接作为文献纳入或排除的依据。
- 主题词检索仍以 PubMed 为主。 Europe PMC 没有独立的 MeSH 字段,做系统检索时可以用 PubMed 的 MeSH 检索式打底,再用 Europe PMC 补充预印本、全文章节和资助维度。